Як дві галочки в API утроїли результат GPT-5.6 на ARC-AGI-3
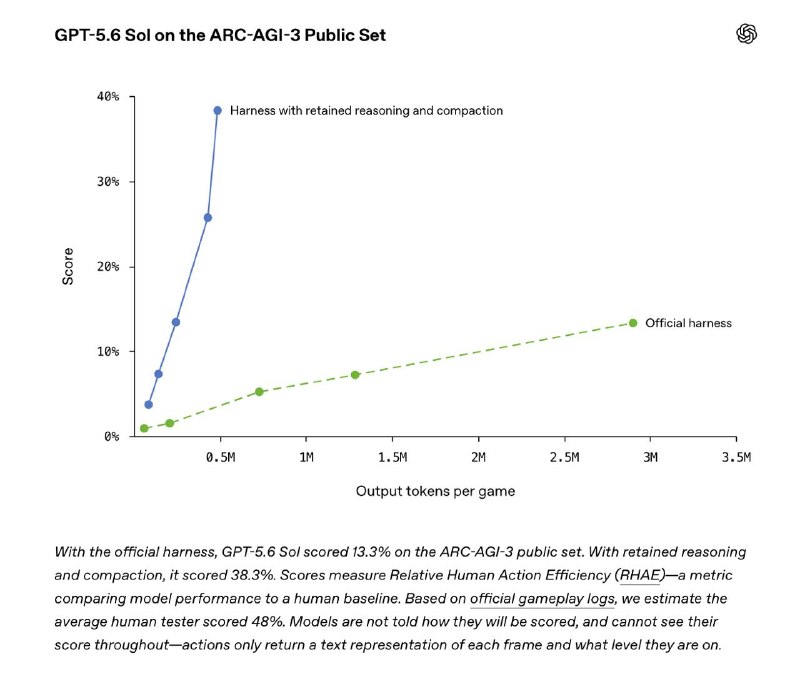
OpenAI опублікувала дослідження, яке показує, як зміни в тестуванні моделі GPT-5.6 вплинули на її результати на ARC-AGI-3.
Як дві галочки в API утроїли результат GPT-5.6 на ARC-AGI-3
Сьогодні OpenAI випустила цікаве дослідження, яке показує, що іноді важливіше, як ми тестуємо, а не що ми тестуємо. Але про все по порядку.
Коли вийшла GPT-5.6 Sol, результати на ARC-AGI-3 для такої потужної моделі виявилися підозріло слабкими – всього 7.8%. І це при тому, що Sol добре пройшла Pokémon FireRed і вирішила, наприклад, гіпотезу про подвійне покриття циклів. Команда вирішила розібратися, в чому справа.
Нагадаємо, що ARC-AGI-3 – це бенчмарк для агентів. Відповідно, моделям для взаємодії зі середовищем потрібна якась обв'язка – харнесс, яка визначає, що модель бачить на кожному кроці, як викликаються інструменти, що відбувається з контекстом тощо. Очікувано, середовище ARC-AGI-3 використовує максимально простий універсальний харнесс, щоб чесно порівнювати моделі між собою. Але для OpenAI саме в цій універсальності і виявилася закладена проблема.
По-перше, після кожної дії в грі весь приватний ризонінг моделі просто видалявся, так що Sol не бачила власних планів і міркувань з попередніх кроків. По-друге, через використання ковзного вікна з ростом історії будь-які старі дії ставали для моделі невидимими.
Але справа в тому, що Sol була спеціально навчена саме з збереженням ризонінга між кроками. Харнесс цю функцію відключив, і результати впали.
А тепер зверніть увагу на графік зверху. Зелене – це результати моделі на публічному сеті ARC-AGI-3 на офіційному харнесі. А синє – на харнесі, в якому просто включили збереження ризонінга між викликами і замінили грубе обрізання історії на стиснення контексту (ті ж налаштування використовуються в продакшені ChatGPT і Codex). 38.3% проти 13.3%, і при цьому витрата токенів на вивід зменшилася в 6 разів. Для порівняння, середній результат людини – 48%.
Мораль від OpenAI: бенчмарк вимірює не тільки модель, але й те, як саме її використовують. Як мінімум, давно пора на подібних бенчмарках використовувати Responses API замість застарілого Chat Completions.
Чому це важливо
АналітикаЦе дослідження підкреслює важливість налаштувань тестування для досягнення точних результатів у бенчмарках AI. Розуміння того, як зміни в тестуванні впливають на результати, може допомогти в подальшому розвитку AI-моделей.
Обговорити новину у спільноті
Діліться своїм досвідом та думками з ШІ-розробниками
Пов'язані матеріали екосистеми
Практичні гайди, термінологія та агентські скіли
Чотири поради щодо резюме від керівника напрямку прикладного ШІ в OpenAI
Керівник напрямку прикладної розробки ШІ в OpenAI Вульфі Бейн назвав чотири ключові правила резюме: стислість, релевантність, акцент на результатах і правильний порядок досягнень.
Сем Альтман змінив назву акаунта в X на Ram Altman
Сем Альтман змінив відображувану назву свого акаунта в X на Ram Altman.
Codex Skills для початківців: як автоматизувати робочі сценарії ШІ-агента
Практичний посібник зі створення та використання Skills у Codex: анатомія SKILL.md, явна та авто-активація, різниця між навичками, скриптами й тулами, Skills API та налаштування меж безпеки.
JSON — структуровані дані для програм, API та AI-агентів
Повний практичний посібник з формату JSON: синтаксичні правила, серіалізація через parse/stringify, робота з REST API, JSON Schema та структурований вивід для штучного інтелекту.