Anthropic révèle le « J-space » : une mémoire de travail pour la réflexion complexe dans Claude
Anthropic a publié une étude majeure sur l'interprétabilité, identifiant un espace interne dédié au raisonnement complexe dans les grands modèles de langage. Cette découverte rapproche le fonctionnement des LLMs de celui du cerveau humain et ouvre la voie à une IA plus transparente.
Anthropic révèle le « J-space » : une mémoire de travail pour la réflexion complexe dans Claude
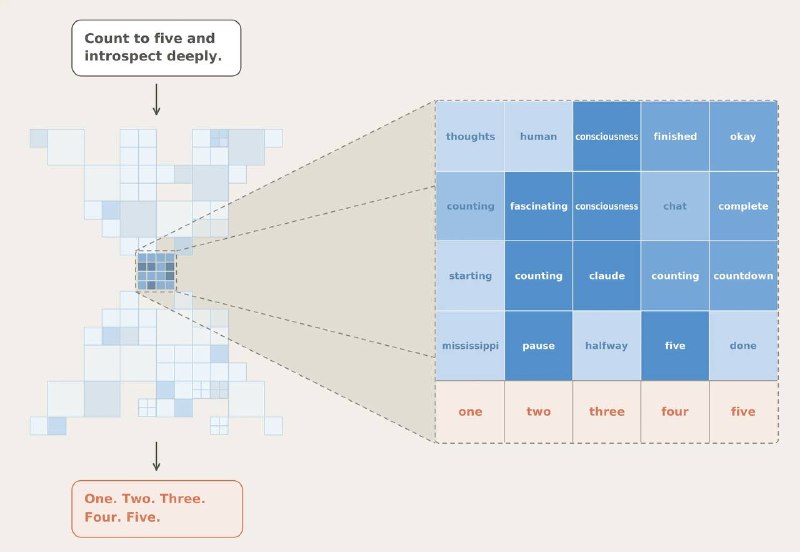
La startup Anthropic a dévoilé l'une des recherches les plus captivantes en matière d'interprétabilité ces derniers temps. Ils ont découvert que dans les grands modèles de langage (LLMs), il existe un ensemble distinct d'activations neuronales servant de mémoire de travail pour la pensée complexe : le fameux J-space.
Nous avons souvent tendance à imaginer les LLMs comme un vaste amas de chiffres, où la connaissance et le raisonnement sont dispersés à travers des milliards de paramètres. Cependant, il semble que ce ne soit pas tout à fait le cas.
Fait intéressant, le cerveau humain fonctionne de manière similaire. Une théorie cognitive avance qu'il est composé de nombreux sous-systèmes spécialisés opérant indépendamment ; mais parfois, certaines informations entrent dans un petit espace de travail partagé, devenant ainsi accessibles à plusieurs zones du cerveau pour être utilisées dans le raisonnement et la prise de décision. C'est précisément ce mécanisme que les chercheurs ont retrouvé dans Claude.
Voici comment fonctionne le J-space :
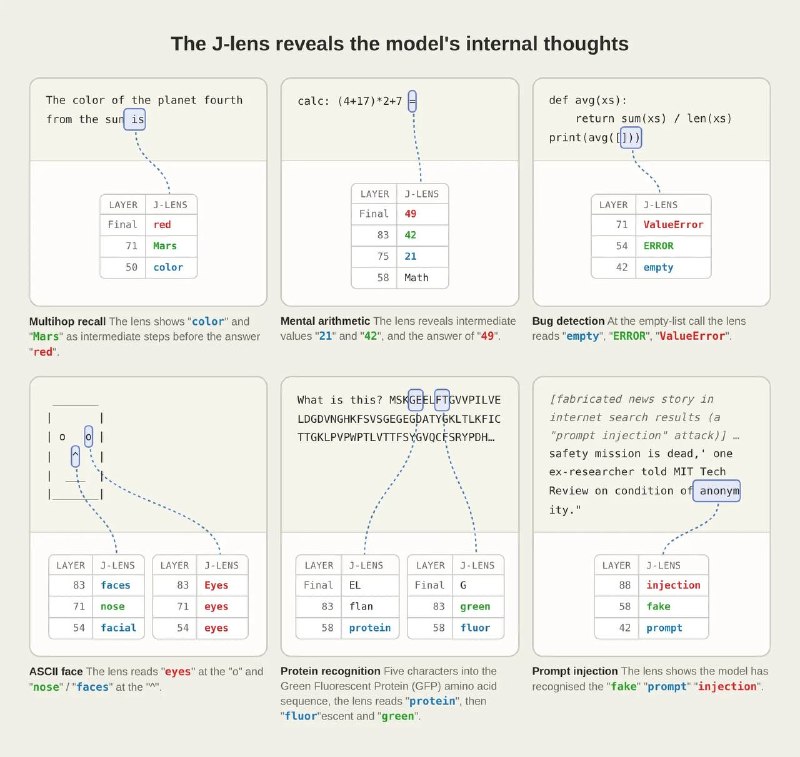
— Le nom provient d'une technique développée par les scientifiques appelée Jacobian Lens. Cette méthode permet de comprendre, sur la base des activations actuelles, quels tokens sont susceptibles d'apparaître à l'avenir. Bien que leur apparition ne soit pas garantie, cela indique que le modèle y pense et les maintient dans le J-space à des fins de raisonnement. En substance, c'est comme lire les pensées de Claude.
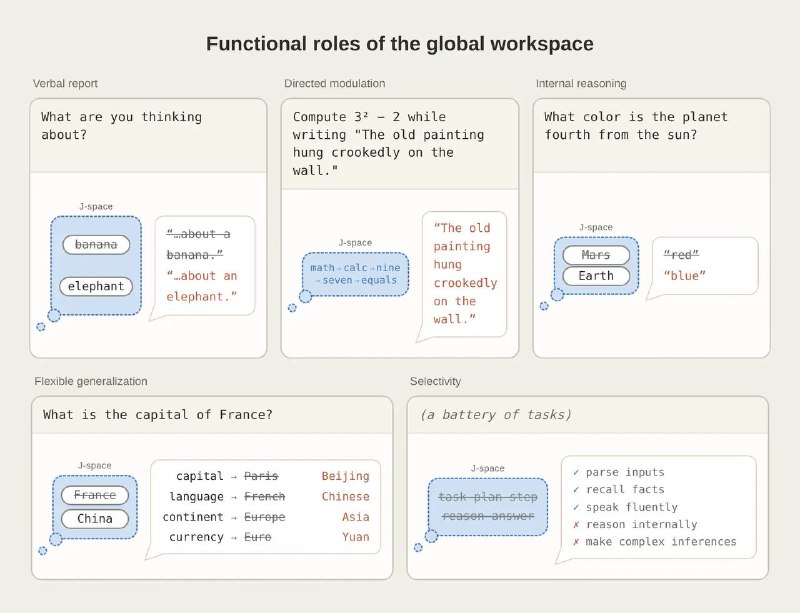
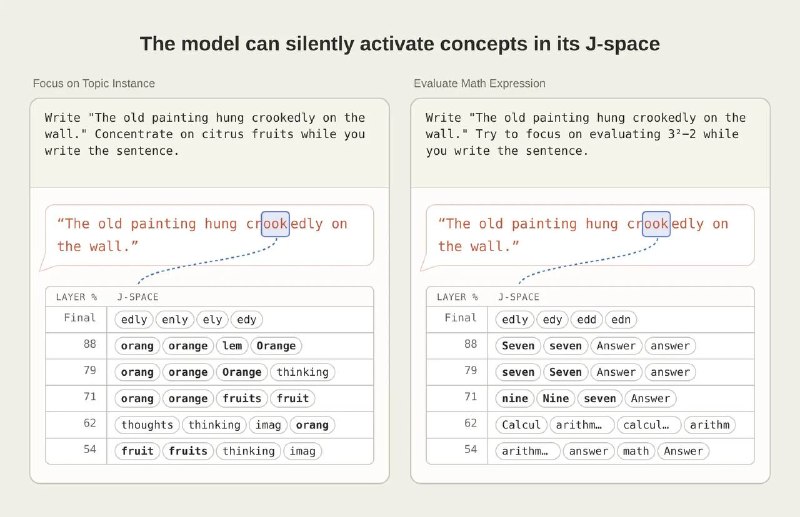
— Si vous demandez à Claude ce à quoi il pense, le contenu du J-space correspond bien à la réponse du modèle. D'autres représentations internes ne possèdent pas cette propriété. De plus, le modèle peut modifier consciemment son J-space. Par exemple, si vous lui dites de « penser aux éléphants tout en résolvant un problème », ce concept apparaîtra dans le J-space. Lors de la résolution d'un problème complexe, les étapes intermédiaires apparaissent également dans le J-space, même si elles ne figurent pas dans les chaînes de pensée explicites.
— Si le J-space est entièrement désactivé, le modèle perd presque toutes ses capacités nécessitant une réflexion complexe et un raisonnement multi-étapes. Par exemple, il n'est plus capable de composer de la poésie.
L'aspect le plus crucial est que le J-space peut être lu et modifié. Anthropic fournit un exemple concret : les chercheurs ont délibérément implanté un objectif caché dans le modèle lors de l'entraînement, puis ont observé comment cet objectif se manifestait dans le J-space, même s'il n'était jamais explicitement mentionné dans les réponses. En altérant les activations dans le J-space, ils pouvaient changer les décisions ultérieures du modèle.
Potentiellement, cela constitue une voie vers la création de modèles sûrs (entièrement ?) et contrôlables. À tout le moins, Anthropic a rendu aujourd'hui la boîte noire un peu plus transparente.
Pourquoi c'est important
AnalyseCette découverte pourrait transformer radicalement notre compréhension du fonctionnement des grands modèles de langage et de leur capacité de raisonnement. La maîtrise du J-space offre des leviers concrets pour développer des systèmes d'IA plus sûrs, interprétables et contrôlables.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs