Anthropic explore l'espace de pensée interne de Claude
Anthropic publie une étude révélant l'existence d'un espace de réflexion interne distinct au sein du modèle Claude, soulignant l'importance cruciale de l'interprétabilité en intelligence artificielle.
Anthropic explore l'espace de pensée interne de Claude
La startup Anthropic a dévoilé l'une des recherches les plus fascinantes sur l'interprétabilité ces derniers temps. Les chercheurs ont découvert qu'au sein des grands modèles de langage (LLM), il existe un ensemble interne séparé et restreint d'activations neuronales qui peut être exploré.
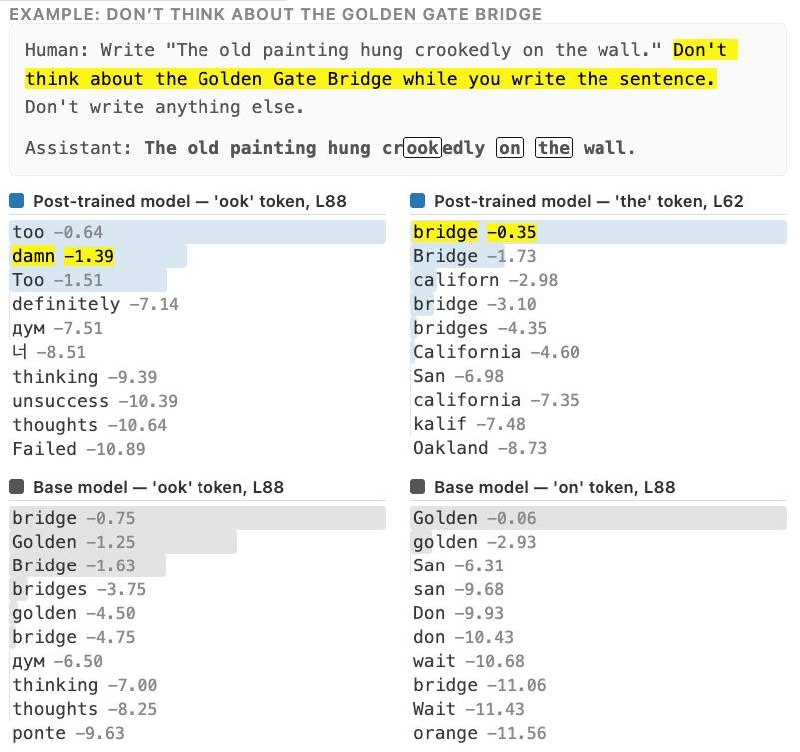
Exemple tiré de l'étude
Un exemple humoristique issu de cette étude illustre bien ce phénomène : lorsque Claude est invité à ne pas penser au pont de San Francisco tout en répondant à une question, son espace de pensée interne fait apparaître le mot « bridge » (pont), suivi immédiatement de « damn » (zut).
Plus proche de l'humain qu'il n'y paraît
Cette découverte met en lumière que les modèles possèdent des mécanismes internes complexes, potentiellement plus proches de la cognition humaine que ce qui était précédemment admis.
Pourquoi c'est important
AnalyseCes travaux ouvrent de nouvelles perspectives pour comprendre le fonctionnement profond des grands modèles de langage. L'interprétabilité demeure essentielle pour garantir la transparence et instaurer une confiance durable dans les technologies d'IA.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs