Anthropic Explora o Espaço de Pensamento Interno do Claude
A Anthropic publicou um estudo inovador que revela o espaço de pensamento interno do modelo Claude, destacando a importância crítica da interpretabilidade na inteligência artificial.
Anthropic Explora o Espaço de Pensamento Interno do Claude
A startup Anthropic lançou um dos trabalhos mais interessantes sobre interpretabilidade nos últimos tempos. A empresa descobriu que, dentro do LLM (modelo de linguagem de grande porte), existe um pequeno conjunto interno separado de ativações neurais que pode ser explorado.
Exemplo do Estudo
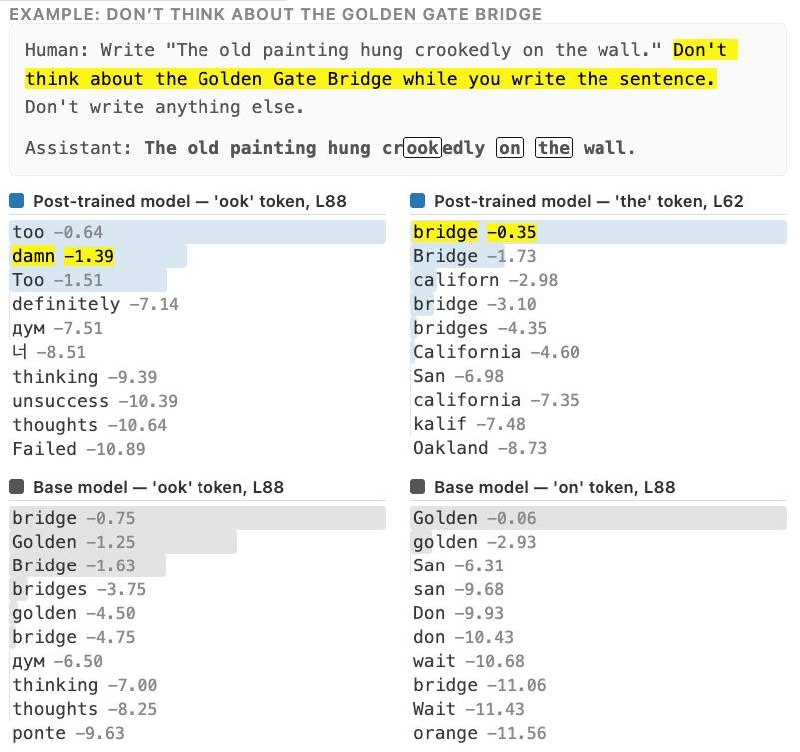
Um exemplo humorístico do estudo: foi pedido ao Claude para não pensar na ponte em São Francisco enquanto respondia a uma pergunta. Em resposta, o espaço de pensamento interno do modelo primeiro trouxe à tona a palavra "ponte", seguida por "droga".
Mais Próximo dos Humanos do que Parece
Esta descoberta enfatiza que os modelos podem ter mecanismos internos complexos que poderiam estar mais próximos do pensamento humano do que se pensava anteriormente.
Por que isso importa
AnáliseEsta pesquisa é significativa pois abre novos horizontes na compreensão de como os grandes modelos de linguagem operam. A interpretabilidade na IA é crucial para garantir transparência e confiança na tecnologia.
Debater na comunidade
Compartilhe suas dúvidas e insights com desenvolvedores