Anthropic erforscht den inneren Gedankenraum von Claude
Anthropic veröffentlicht eine bahnbrechende Studie zur Interpretierbarkeit, die einen separaten neuronalen Aktivierungsraum im LLM Claude aufdeckt. Diese Entdeckung deutet darauf hin, dass KI-Modelle komplexere, menschenähnliche Denkmechanismen besitzen als bisher angenommen.
Anthropic erforscht den inneren Gedankenraum von Claude
Das Start-up Anthropic hat eines der faszinierendsten Werke zur Interpretierbarkeit (Explainable AI) der jüngsten Vergangenheit vorgelegt. Die Forscher entdeckten, dass innerhalb des großen Sprachmodells (LLM) ein separater, kleiner Satz neuronaler Aktivierungen existiert, der gezielt untersucht werden kann.
Beispiel aus der Studie
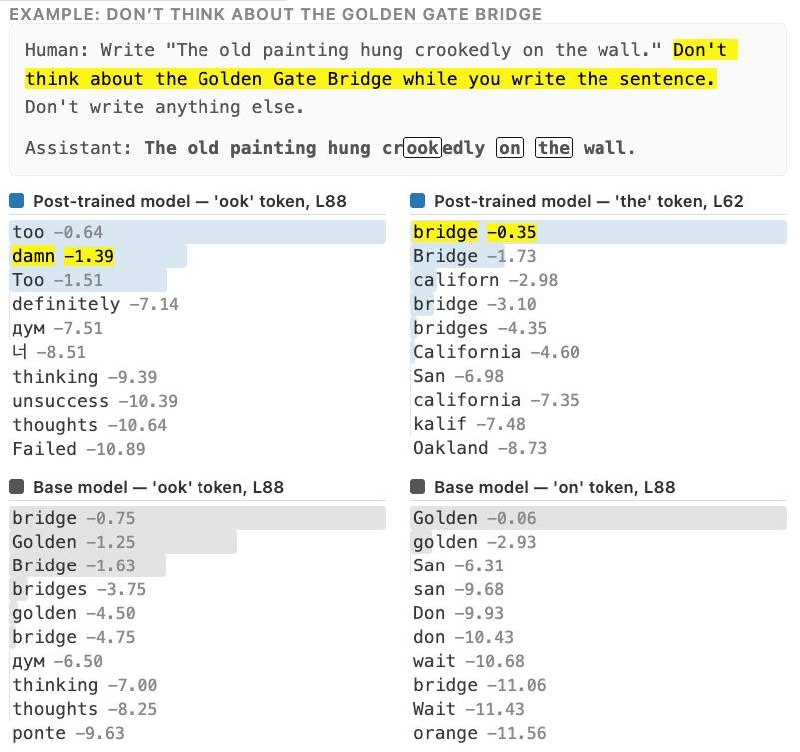
Ein humorvolles Beispiel aus der Untersuchung veranschaulicht diesen Mechanismus: Claude wird angewiesen, bei der Beantwortung einer Frage nicht an die Brücke in San Francisco zu denken. Als Reaktion darauf bringt der interne Gedankenraum des Modells zunächst das Wort „Brücke“ hervor, gefolgt von dem Ausruf „Verdammt“.
Näher am Menschen als gedacht
Diese Entdeckung unterstreicht, dass Modelle über komplexe interne Mechanismen verfügen könnten, die dem menschlichen Denken näher stehen als bislang vermutet. Sie wirft neue Fragen nach der Natur der künstlichen Intelligenz und ihren kognitiven Prozessen auf.
Warum das wichtig ist
AnalyseDiese Forschung ist von großer Bedeutung, da sie neue Horizonte für das Verständnis der Funktionsweise großer Sprachmodelle eröffnet. Die Interpretierbarkeit von KI ist entscheidend, um Transparenz und Vertrauen in moderne Technologien zu gewährleisten.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern