Anthropic entdeckt den „J-Raum“ in Claude für komplexes Denken
Anthropic hat eine bahnbrechende Studie veröffentlicht, die den sogenannten J-Raum als internes Arbeitsgedächtnis für komplexes Denken im Claude-Modell identifiziert. Diese Entdeckung könnte unser Verständnis der Funktionsweise großer Sprachmodelle grundlegend verändern.
Anthropic entdeckt den „J-Raum“ in Claude für komplexes Denken
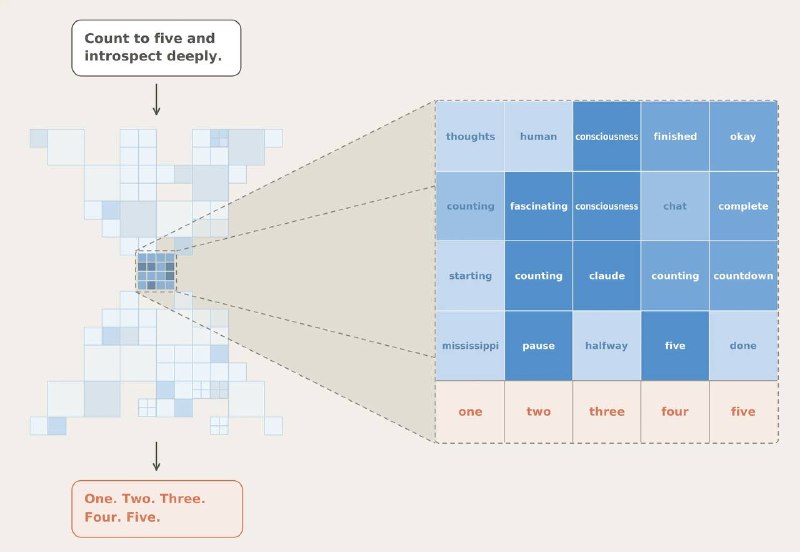
Das Start-up Anthropic hat eines der interessantesten Werke zur Interpretierbarkeit (Interpretability) der jüngsten Zeit veröffentlicht. Die Forscher entdeckten, dass es in großen Sprachmodellen (LLMs) einen separaten Satz neuronaler Aktivierungen gibt, der als Arbeitsgedächtnis für komplexes Denken dient: den sogenannten J-Raum.
Wir stellen uns LLMs oft als ein gewaltiges Durcheinander von Zahlen vor, bei dem Wissen und Schlussfolgerungen über Milliarden von Parametern verteilt sind. Es scheint jedoch nicht ganz so zu sein.
Interessanterweise funktioniert das menschliche Gehirn auf ähnliche Weise. Eine kognitive Theorie besagt, dass es aus vielen spezialisierten Subsystemen besteht, die unabhängig voneinander arbeiten; manchmal gelangt jedoch Information in einen kleinen gemeinsamen Arbeitsbereich, der für viele Bereiche des Gehirns zugänglich wird und für Schlussfolgerungen sowie Entscheidungsfindung genutzt werden kann. Genau diesen Mechanismus haben die Forscher in Claude gefunden.
So funktioniert der J-Raum:
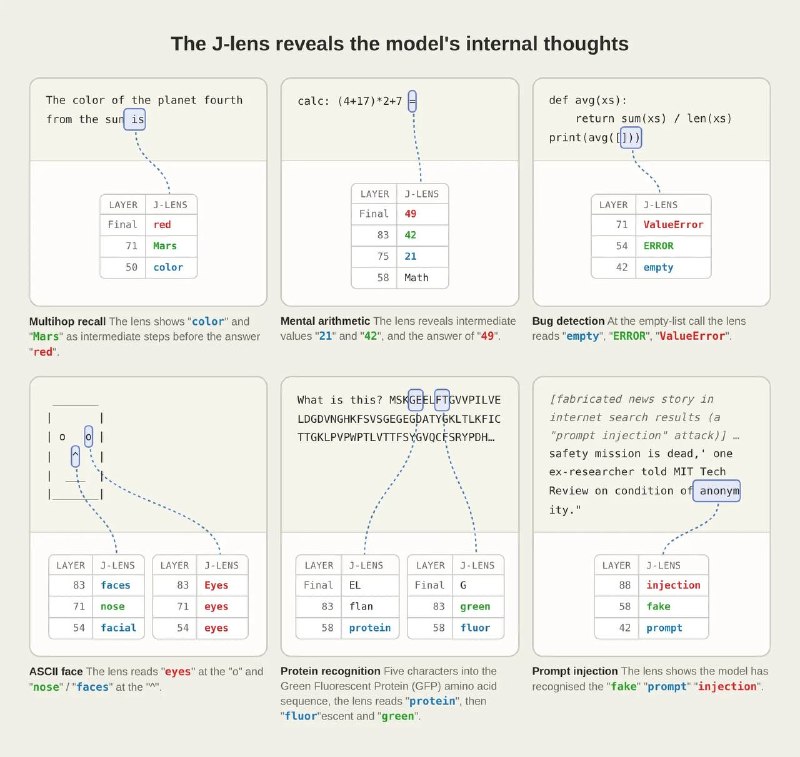
— Der Name leitet sich von einer Technik ab, die Wissenschaftler als Jacobian Lens bezeichnen. Diese Methode ermöglicht es, basierend auf aktuellen Aktivierungen zu verstehen, welche Token mit höherer Wahrscheinlichkeit in Zukunft auftreten werden. Zwar ist ihr Auftreten nicht garantiert, aber es zeigt an, dass das Modell über sie nachdenkt und sie im J-Raum für Schlussfolgerungszwecke behält. Im Wesentlichen ist dies das Lesen der Gedanken von Claude.
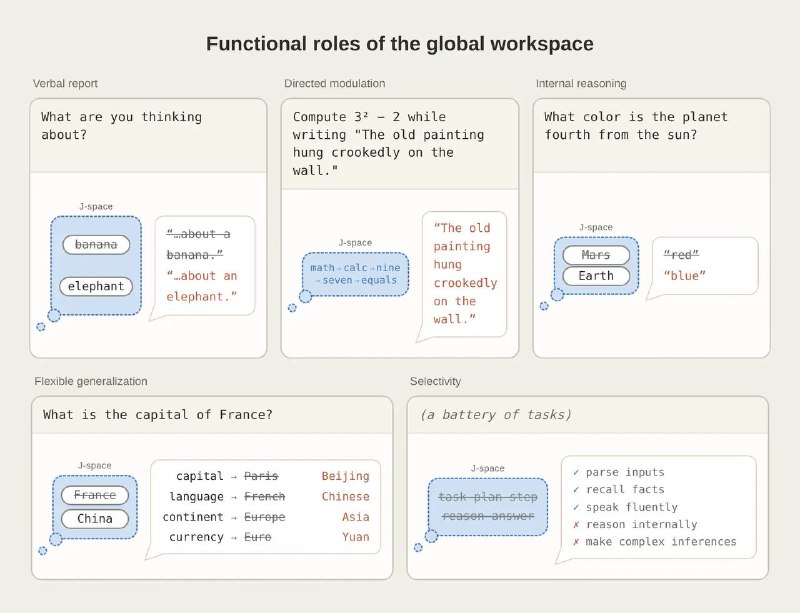
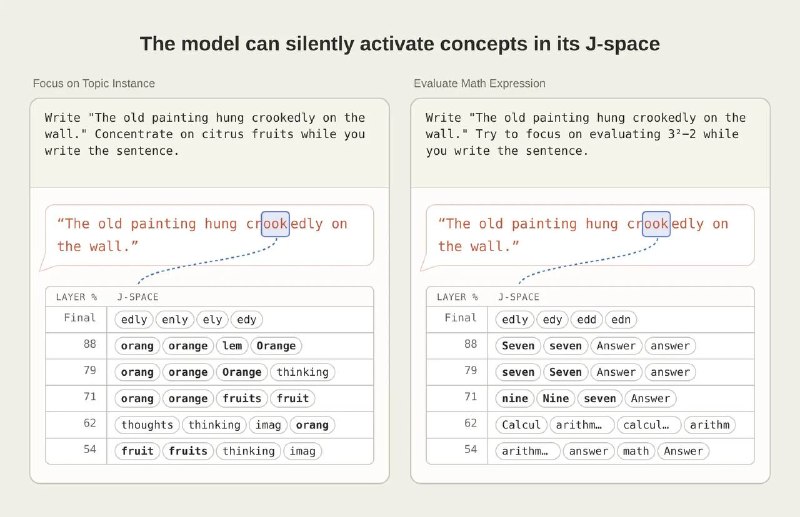
— Wenn man Claude fragt, worüber es nachdenkt, stimmen die Inhalte des J-Raums gut mit der Antwort des Modells überein. Andere interne Repräsentationen besitzen diese Eigenschaft nicht. Zusätzlich kann das Modell den J-Raum bewusst ändern. Wenn man ihm beispielsweise sagt, es soll „während der Problemlösung an Elefanten denken“, erscheint dieses Konzept im J-Raum. Beim Lösen komplexer Probleme treten auch Zwischenschritte im J-Raum auf, selbst wenn sie nicht in den Gedankengängen (Chains of Thought) vorhanden sind.
— Wenn der J-Raum vollständig deaktiviert wird, verliert das Modell fast alle Fähigkeiten, die komplexes Denken und mehrstufiges Schlussfolgern erfordern. Zum Beispiel kann es keine Gedichte mehr verfassen.
Der wichtigste Aspekt dabei ist, dass der J-Raum gelesen und modifiziert werden kann. Anthropic liefert ein Beispiel: Forscher implantierten während des Trainings absichtlich ein verstecktes Ziel in das Modell und beobachteten anschließend, wie sich dieses Ziel im J-Raum manifestierte, obwohl es nie explizit in den Antworten erwähnt wurde. Durch die Änderung der Aktivierungen im J-Raum konnten sie die nachfolgenden Entscheidungen des Modells beeinflussen.
Potenziell ist dies ein Weg zur Schaffung (vollständig?) sicherer und steuerbarer Modelle. Zumindest hat Anthropic heute die Black Box etwas transparenter gemacht.
Warum das wichtig ist
AnalyseDiese Entdeckung könnte unser Verständnis davon, wie große Sprachmodelle funktionieren und zu komplexem Denken fähig sind, erheblich verändern. Das Verständnis des J-Raums könnte dazu beitragen, sicherere und besser kontrollierbare KI-Systeme zu entwickeln.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern