Anthropic odkrywa J-space w modelu Claude: klucz do złożonego myślenia
Firma Anthropic opublikowała przełomowe badania ujawniające istnienie J-space – wewnętrznej przestrzeni roboczej odpowiedzialnej za złożone rozumowanie w modelu Claude. Odkrycie to może fundamentalnie zmienić nasze postrzeganie działania dużych modeli językowych.
Anthropic odkrywa J-space w modelu Claude: klucz do złożonego myślenia
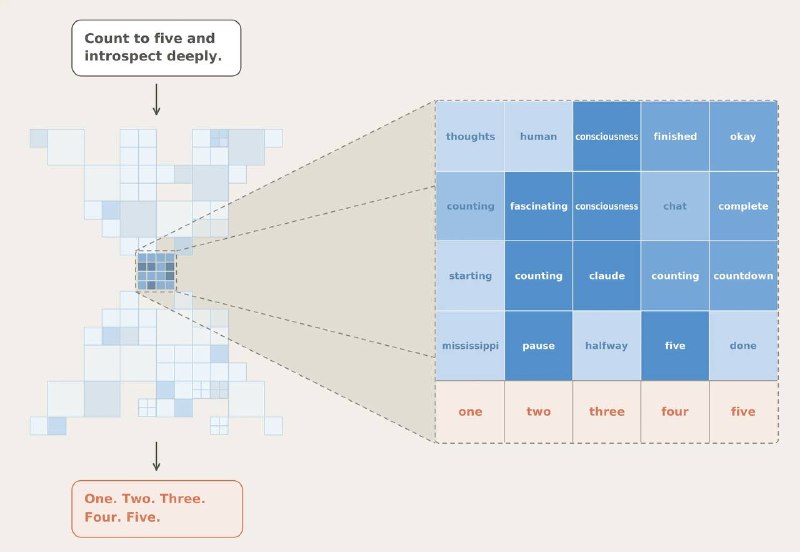
Startup Anthropic zaprezentował jedną z najbardziej fascynujących prac dotyczących interpretowalności AI w ostatnich czasach. Badacze odkryli, że w dużych modelach językowych (LLM) istnieje odrębny zestaw aktywacji neuronowych pełniący funkcję pamięci roboczej dla złożonych procesów myślowych, zwany J-space.
Często wyobrażamy sobie LLM jako ogromny zbiór liczb, gdzie wiedza i rozumowanie są rozproszone wśród miliardów parametrów. Okazuje się jednak, że rzeczywistość jest bardziej uporządkowana.
Co ciekawe, ludzki mózg działa w podobny sposób. Istnieje teoria kognitywna głosząca, że składa się on z wielu wyspecjalizowanych podsystemów działających niezależnie; czasem jednak pewne informacje trafiają do małej, wspólnej przestrzeni roboczej, stając się dostępne dla wielu obszarów mózgu i umożliwiając wnioskowanie oraz podejmowanie decyzji. Dokładnie ten mechanizm badacze zidentyfikowali w modelu Claude.
Jak działa J-space:
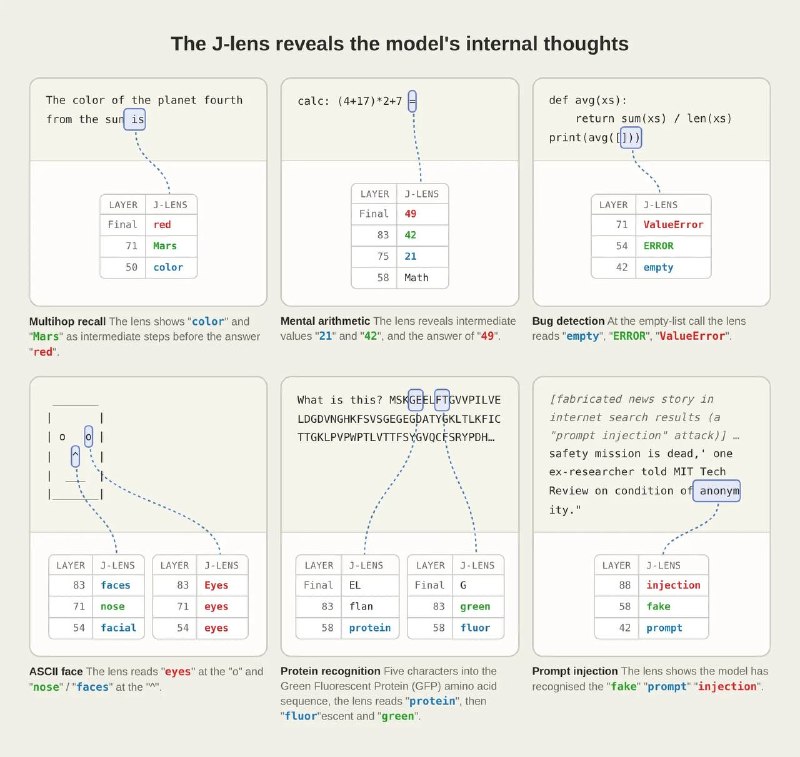
— Nazwa pochodzi od techniki opracowanej przez naukowców, zwanej Jacobian Lens. Pozwala ona na podstawie bieżących aktywacji zrozumieć, które tokeny mają większe prawdopodobieństwo wystąpienia w przyszłości. Choć ich pojawienie się nie jest gwarantowane, wskazuje to, że model „myśli” o nich i przechowuje je w J-space na potrzeby rozumowania. W istocie jest to czytanie myśli modelu Claude.
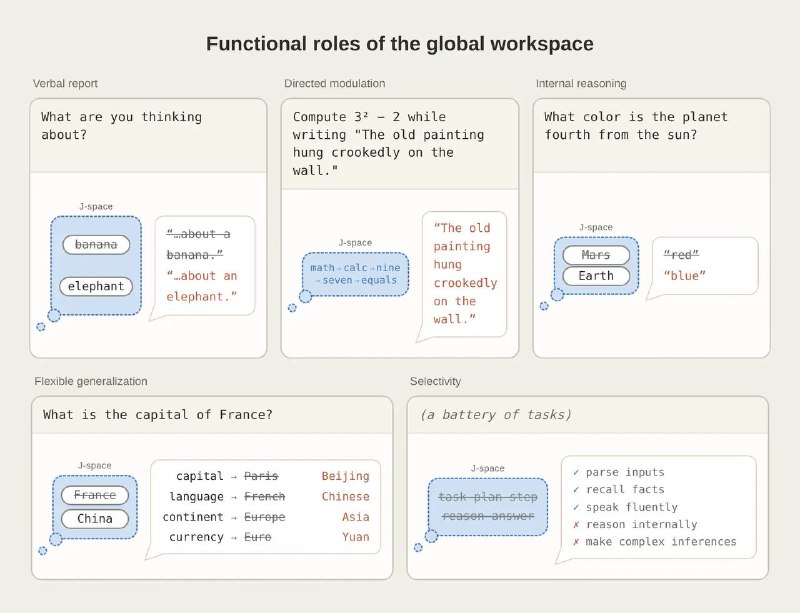
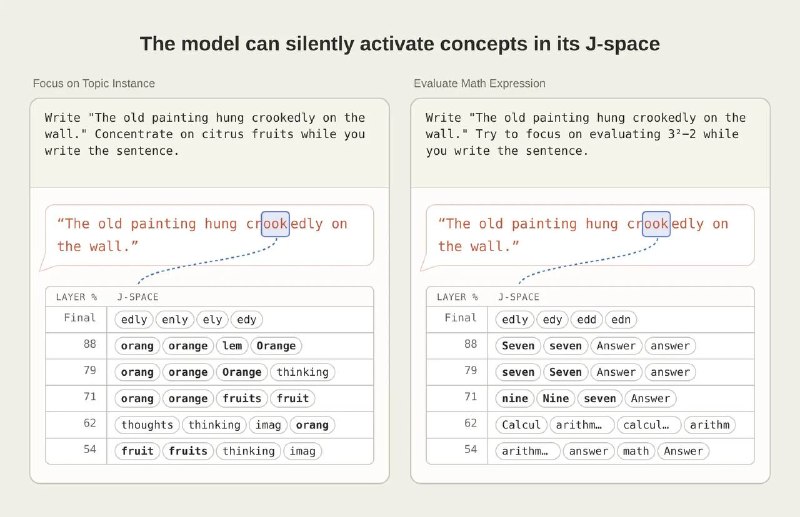
— Jeśli zapytasz Claude, o czym myśli, zawartość J-space dobrze koresponduje z odpowiedzią modelu. Inne wewnętrzne reprezentacje nie posiadają tej właściwości. Ponadto model może świadomie modyfikować J-space. Na przykład, jeśli poprosisz go o „myślenie o słoniach podczas rozwiązywania problemu”, ten koncept pojawi się w J-space. Podczas rozwiązywania złożonych problemów, pośrednie kroki również pojawiają się wewnątrz J-space, nawet jeśli nie są widoczne w łańcuchach myślenia.
— Jeśli J-space zostanie całkowicie wyłączony, model niemal traci zdolności wymagające złożonego myślenia i wieloetapowego rozumowania. Na przykład przestaje być w stanie komponować poezję.
Najważniejszym aspektem tego odkrycia jest możliwość odczytywania i modyfikowania J-space. Anthropic podaje przykład: badacze celowo wszczepili ukryty cel w model podczas treningu, a następnie obserwowali, jak ten cel manifestuje się w J-space, mimo że nigdy nie został jawnie wypowiedziany w odpowiedziach. Zmieniając aktywacje w J-space, mogli wpływać na późniejsze decyzje modelu.
Potencjalnie jest to ścieżka do tworzenia (w pełni?) bezpiecznych i kontrolowalnych modeli. Co najmniej dziś Anthropic sprawił, że czarna skrzynka stała się nieco bardziej przejrzysta.
Dlaczego to ważne
AnalizaTo odkrycie może znacząco zmienić nasze rozumienie funkcjonowania dużych modeli językowych i ich zdolności do złożonego myślenia. Zrozumienie mechanizmu J-space może przyczynić się do rozwoju bezpieczniejszych i bardziej przewidywalnych systemów AI.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami