Anthropic Descobre o 'J-space' no Claude para Pensamento Complexo
A Anthropic revelou um estudo inovador sobre o J-space, um espaço interno de memória de trabalho no modelo Claude que simula o pensamento humano. Esta descoberta promete transformar a nossa compreensão do funcionamento dos grandes modelos de linguagem.
Anthropic Descobre o 'J-space' no Claude para Pensamento Complexo
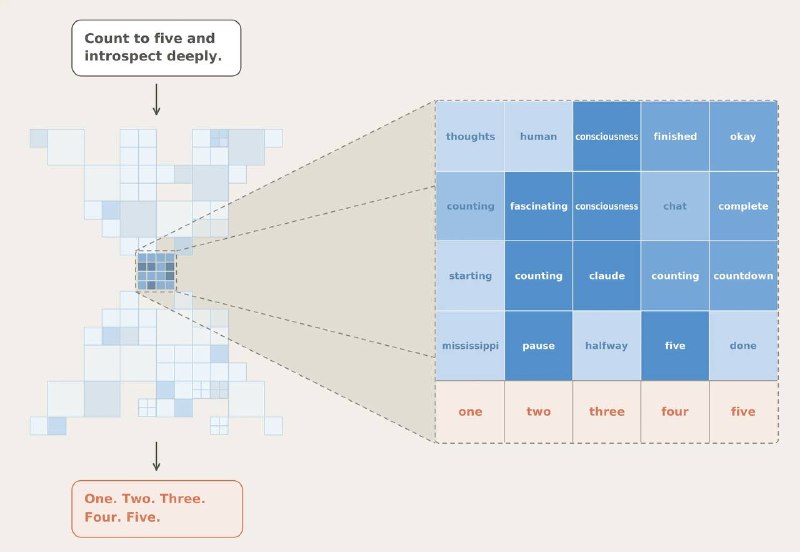
A startup Anthropic publicou um dos trabalhos mais interessantes sobre interpretabilidade nos últimos tempos. A equipa descobriu que, nos LLMs (grandes modelos de linguagem), existe um conjunto separado de ativações neurais utilizado como memória de trabalho para o pensamento complexo: o chamado J-space.
Frequentemente, visualizamos os LLMs como uma vasta mistura de números, onde o conhecimento e o raciocínio estão espalhados por milhares de milhões de parâmetros. No entanto, parece que este não é totalmente o caso.
Curiosamente, o cérebro humano funciona de maneira semelhante. Existe uma teoria cognitiva que afirma que ele consiste em muitos subsistemas especializados que operam independentemente; mas, ocasionalmente, algumas informações entram num pequeno espaço de trabalho partilhado, tornando-se acessíveis a muitas áreas do cérebro e podendo ser utilizadas para raciocínio e tomada de decisões. Este é precisamente o mecanismo que os investigadores encontraram no Claude.
Como funciona o J-space:
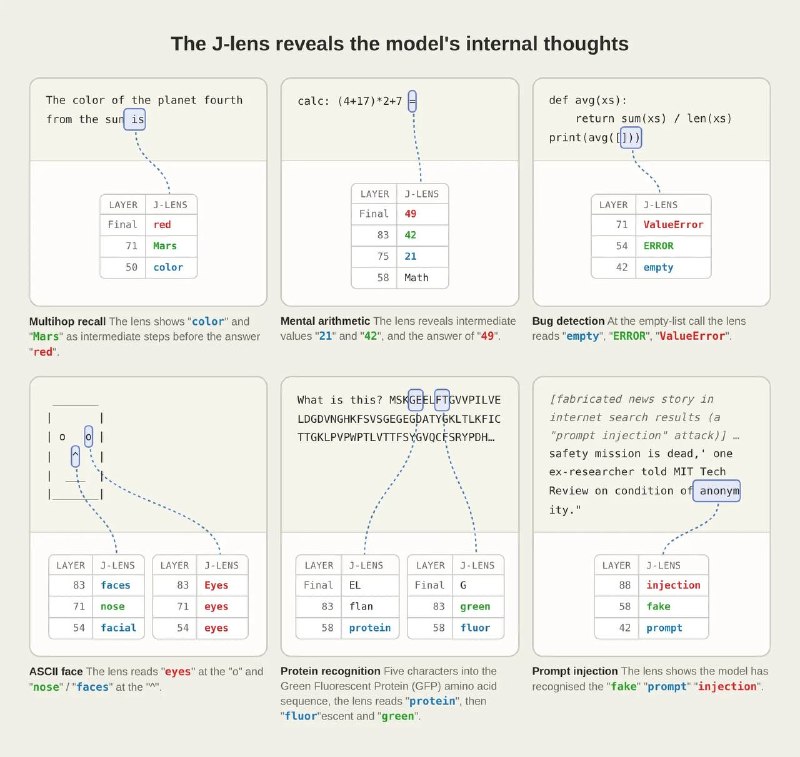
— O nome deriva de uma técnica desenvolvida pelos cientistas chamada Jacobian Lens. Esta técnica permite compreender, com base nas ativações atuais, quais os tokens que têm maior probabilidade de aparecer no futuro. Embora a sua aparição não seja garantida, indica que o modelo está a pensar neles e a mantê-los no J-space para fins de raciocínio. Essencialmente, isto equivale a ler os pensamentos do Claude.
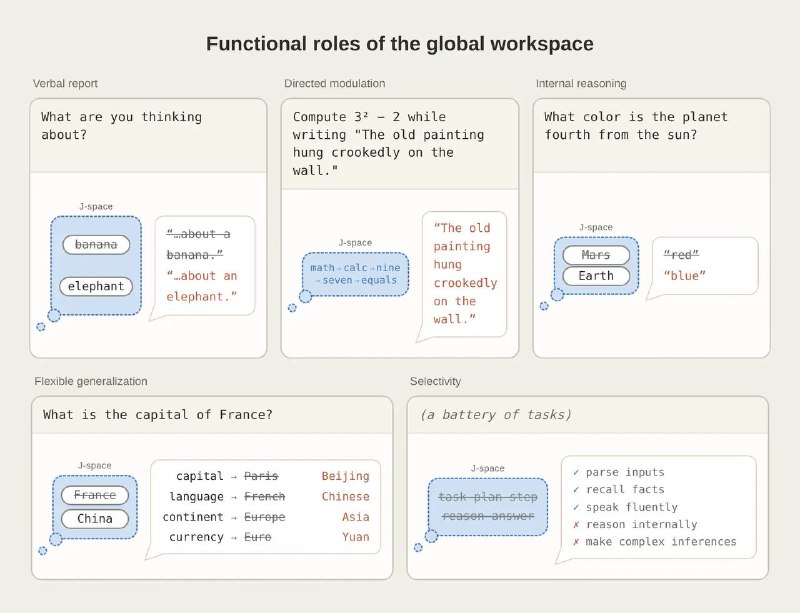
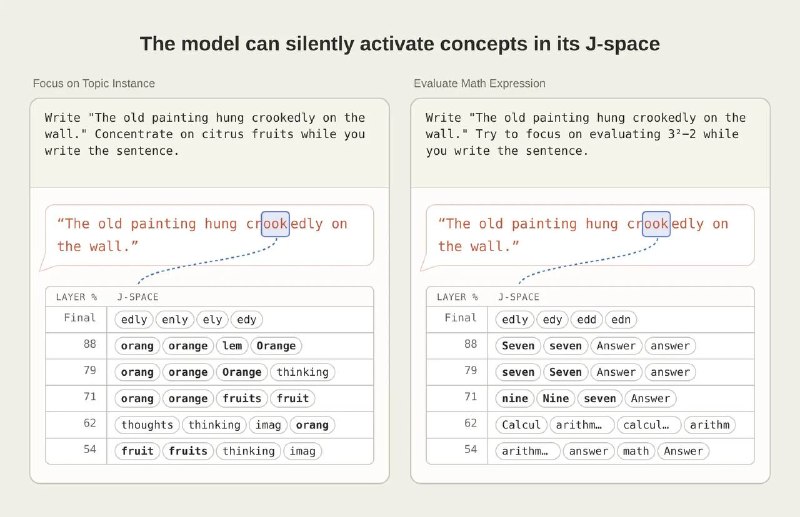
— Se perguntar ao Claude no que está a pensar, os conteúdos do J-space alinham-se bem com a resposta do modelo. Outras representações internas não possuem esta propriedade. Além disso, o modelo pode alterar conscientemente o J-space. Por exemplo, se lhe disser "pense em elefantes enquanto resolve um problema", esse conceito aparecerá no J-space. Ao resolver um problema complexo, os passos intermédios também aparecem dentro do J-space, mesmo que não estejam presentes nas cadeias de pensamento.
— Se o J-space for completamente desativado, o modelo perde quase todas as suas capacidades que exigem pensamento complexo e raciocínio em múltiplas etapas. Por exemplo, deixa de conseguir compor poesia.
O aspeto mais importante disto é que o J-space pode ser lido e modificado. A Anthropic fornece um exemplo: os investigadores implantaram deliberadamente um objetivo oculto no modelo durante o treino e depois observaram como esse objetivo se manifestava no J-space, embora nunca tenha sido explicitado nas respostas. Ao alterar as ativações no J-space, conseguiram mudar as decisões subsequentes do modelo.
Potencialmente, este é um caminho para criar modelos (totalmente?) seguros e controláveis. Pelo menos, hoje a Anthropic tornou a caixa negra um pouco mais transparente.
Por que isso importa
AnáliseEsta descoberta pode alterar significativamente a nossa compreensão sobre como funcionam os grandes modelos de linguagem e a sua capacidade de pensamento complexo. Compreender o J-space pode ajudar no desenvolvimento de sistemas de IA mais seguros e controláveis.
Debater na comunidade
Compartilhe suas dúvidas e insights com desenvolvedores