Anthropic нашли J-space в Claude для сложного мышления
Anthropic представили революционное исследование, в котором обнаружили J-space — внутреннее пространство для сложного мышления в модели Claude. Это открытие может изменить наше понимание работы больших языковых моделей.
Anthropic нашли J-space в Claude для сложного мышления
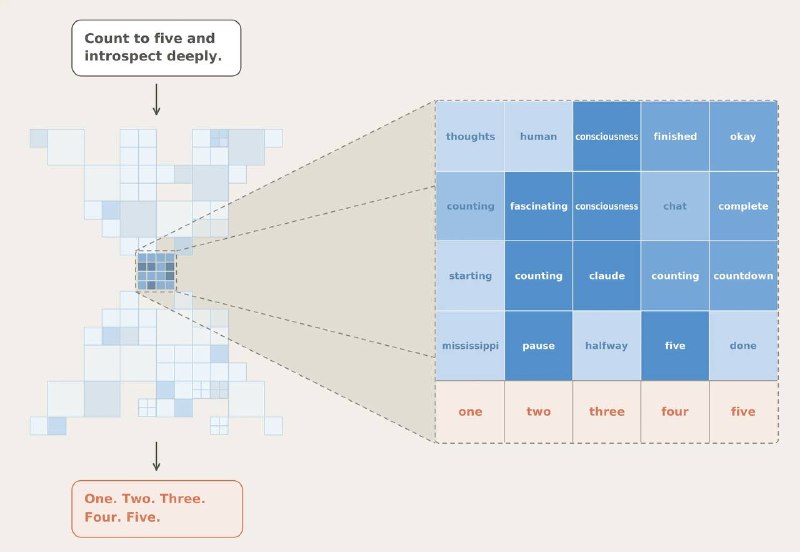
Стартап Anthropic выпустил одну из самых интересных работ по интерпретируемости за последнее время. Они обнаружили, что в LLM (больших языковых моделях) есть отдельный набор нейронных активаций, который используется как рабочая память для сложного мышления: так называемый J-space.
Мы часто представляем LLM как огромную мешанину чисел, где знания и рассуждения размазаны по миллиардам параметров. Но похоже, что это не совсем так.
Любопытно, что человеческий мозг работает похожим образом. Есть когнитивная теория, утверждающая, что он состоит из множества специализированных подсистем, которые работают независимо; но иногда какая-то информация попадает в небольшой общий рабочий пространство, становится доступной сразу многим областям мозга и может использоваться для рассуждений и принятия решений. Именно такой механизм исследователи обнаружили в Claude.
Вот как работает J-space:
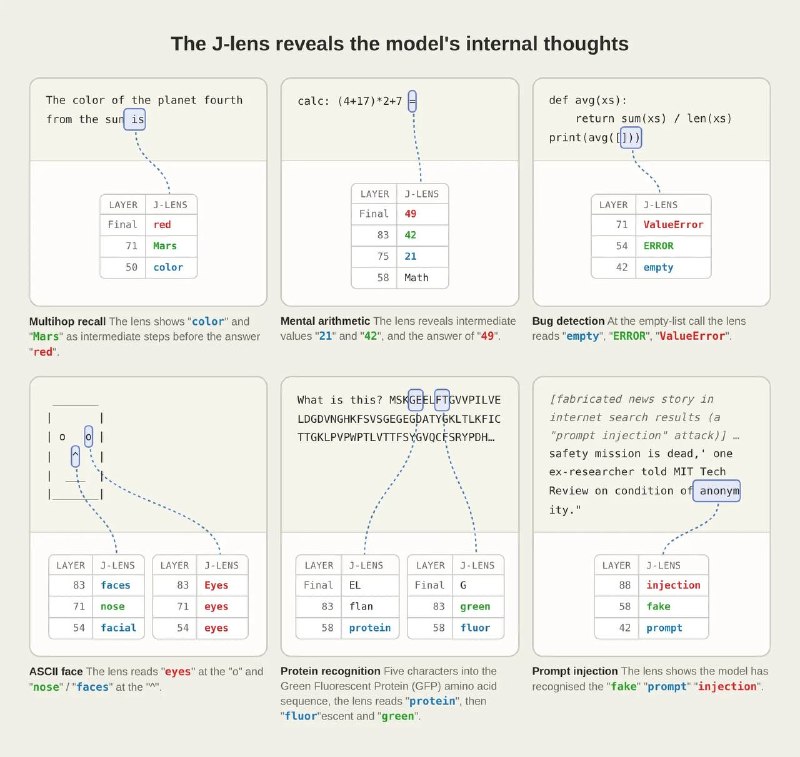
— Название происходит от разработанной учеными техники Jacobian Lens. Она позволяет по текущим активациям понимать, какие токены с большей вероятностью появятся в будущем. При этом то, что они появятся — далеко не факт, но это значит, что модель о них думает и держит их в J-space, чтобы использовать в рассуждениях. По сути, это чтение мыслей Claude.
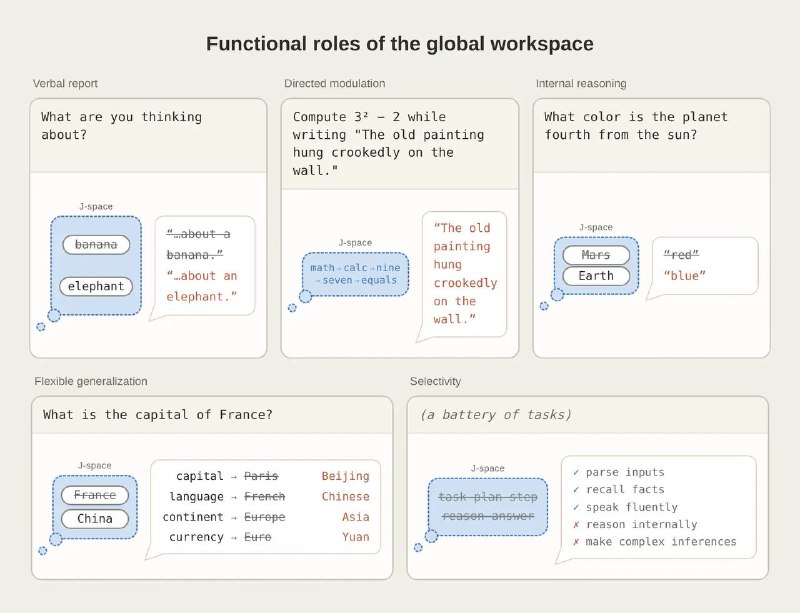
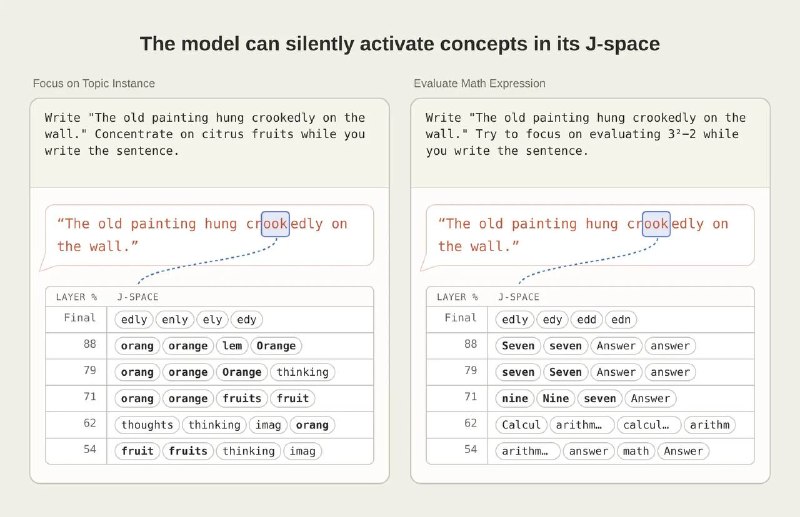
— Если спросить Claude, о чем он думает, то содержимое J-space хорошо совпадает с ответом модели. Другие внутренние представления таким свойством не обладают. А еще модель умеет сознательно менять J-space. Например, если сказать ей «думай о слонах, пока решаешь задачу», то эта концепция появится в J-space. При решении сложной задачи промежуточные шаги тоже появляются именно внутри J-space, даже если их при этом нет в цепочках мыслей.
— Если полностью отключить J-space, то у модели почти исчезают способности, требующие сложного мышления и многошагового рассуждения. Например, она больше не может сочинять стихи.
Самое важное во всем этом то, что J-space можно читать и менять. Anthropic приводят пример: исследователи специально внедряли модели скрытую цель во время обучения и затем наблюдали, как эта цель проявляется в J-space, хотя в ответах напрямую она ни разу не озвучивалась. При этом изменяя активации в J-space, они могли менять дальнейшие решения модели.
Потенциально это путь к тому, чтобы создавать (полностью?) безопасные и контролируемые модели. По крайней мере, сегодня Anthropic уже сделали черный ящик немного более прозрачным.
Почему это важно
АналитикаЭто открытие может существенно изменить наше понимание работы больших языковых моделей и их способности к сложному мышлению. Понимание J-space может помочь в создании более безопасных и контролируемых AI-систем.
Обсудить в сообществе
Делитесь опытом и мыслями с ИИ-разработчиками
Связанные материалы экосистемы
Практические гайды, терминология и агентские скиллы
Claude становится умнее
Claude становится умнее: сообщение указывает на развитие модели и возможные улучшения её возможностей.
AI-дайджест за две недели: GPT-6.1 Terra, Gemini 4 Carbon, Mistral Large 4 и изменения тарифов
Свежий обзор новостей AI: обновления LLM, изменения подписок OpenAI и Anthropic, новые world-модели, видео-генераторы и корпоративные детали.
Claude Haiku (Скоростные компактные модели Anthropic)
Самая компактная и быстрая модель в линейке Anthropic. Создана для молниеносных ответов, массовой классификации текстов, извлечения данных и агентской маршрутизации при минимальных затратах.
Claude Opus (Флагманская интеллектуальная модель Anthropic)
Самая мощная тяжеловесная модель в семействе Anthropic. Создана для сложного философского и научного анализа, написания многослойных текстов и глубокого понимания контекста.