Anthropic bada wewnętrzny świat myśli modelu Claude
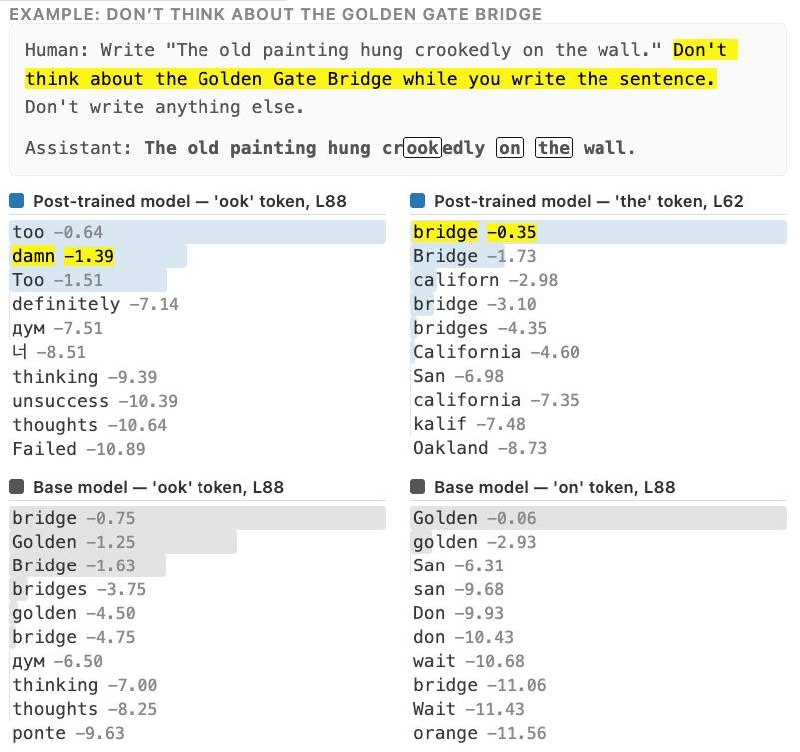
Firma Anthropic opublikowała przełomowe badanie ujawniające strukturę wewnętrznego przetwarzania modelu Claude. Odkrycie to podkreśla kluczową rolę interpretowalności w rozwoju sztucznej inteligencji.
Anthropic bada wewnętrzny świat myśli modelu Claude
Startup Anthropic zaprezentował jedną z najbardziej fascynujących prac dotyczących interpretowalności AI w ostatnich czasach. Badacze odkryli, że wewnątrz dużych modeli językowych (LLM) istnieje wydzielony, niewielki zestaw aktywacji neuronowych, który można poddawać analizie.
Przykład z badania
Humorystyczny przykład przytoczony w raporcie ilustruje ten mechanizm: gdy modelowi Claude polecono, by nie myślał o moście w San Francisco podczas odpowiadania na pytanie, jego wewnętrzna przestrzeń myślowa najpierw wygenerowała słowo „most”, a następnie „do diabła”.
Bardziej ludzkie niż się wydaje
To odkrycie sugeruje, że modele AI mogą dysponować złożonymi mechanizmami wewnętrznymi, które są bliższe ludzkiemu sposobowi myślenia, niż dotychczas zakładano.
Dlaczego to ważne
AnalizaBadanie to otwiera nowe horyzonty w zrozumieniu działania dużych modeli językowych. Interpretowalność jest fundamentem budowania przejrzystości i zaufania do technologii AI.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami