Anthropic Explora o Espaço de Pensamento Interno do Claude
A Anthropic publicou um estudo inovador que revela o espaço de pensamento interno do modelo Claude, destacando a importância crítica da interpretabilidade na inteligência artificial.
Anthropic Explora o Espaço de Pensamento Interno do Claude
A startup Anthropic lançou um dos trabalhos mais interessantes sobre interpretabilidade nos últimos tempos. A empresa descobriu que, dentro do LLM (modelo de linguagem de grande porte), existe um pequeno conjunto interno separado de ativações neurais que pode ser explorado.
Exemplo do Estudo
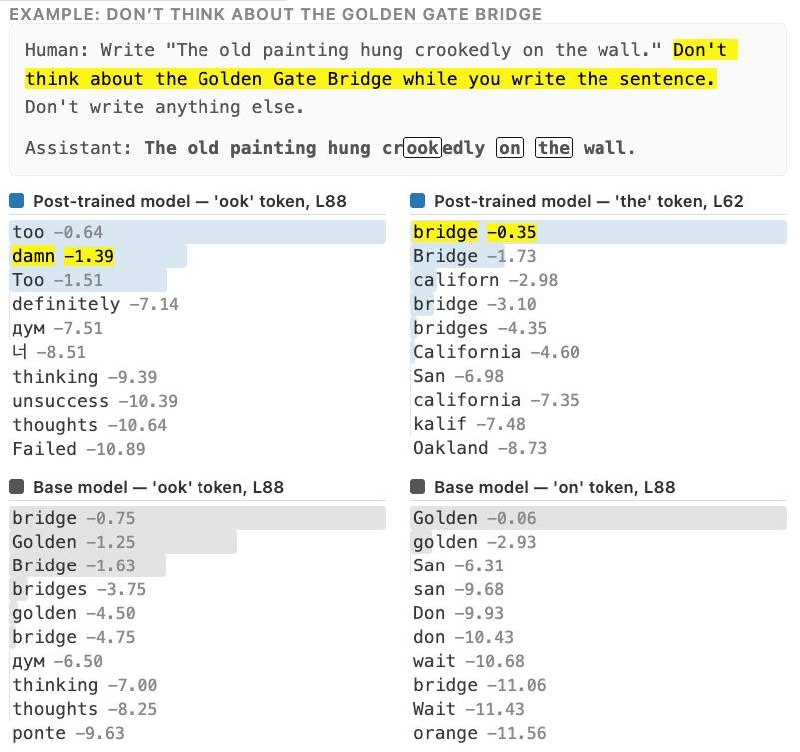
Um exemplo humorístico do estudo: foi pedido ao Claude para não pensar na ponte em São Francisco enquanto respondia a uma pergunta. Em resposta, o espaço de pensamento interno do modelo primeiro trouxe à tona a palavra "ponte", seguida por "droga".
Mais Próximo dos Humanos do que Parece
Esta descoberta enfatiza que os modelos podem ter mecanismos internos complexos que poderiam estar mais próximos do pensamento humano do que se pensava anteriormente.
Por que isso importa
AnáliseEsta pesquisa é significativa pois abre novos horizontes na compreensão de como os grandes modelos de linguagem operam. A interpretabilidade na IA é crucial para garantir transparência e confiança na tecnologia.
Debater na comunidade
Compartilhe suas dúvidas e insights com desenvolvedores
Relacionado no ecossistema
Guias práticos, terminologia essencial e skills de agentes
Claude fica mais inteligente
Claude fica mais inteligente, indicando possíveis melhorias nas capacidades do modelo.
Anthropic gasta mais no uso interno do Claude do que em salários
No seu documento de IPO, a Anthropic revelou que o uso interno do Claude superou os salários dos funcionários quando calculado às tarifas para clientes.
Formato Markdown: guia completo para trabalhar com IA e automação
Guia prático abrangente sobre a sintaxe do Markdown para desenvolvimento de IA: CommonMark, hierarquia de cabeçalhos, tabelas GFM, escape, prompts de sistema e arquivos CLAUDE.md.
Controle do Computador por IA (Computer Use)
Tecnologia da Anthropic (apresentada nos modelos Claude 3.5 Sonnet) que permite à rede neural controlar o sistema operacional como um ser humano: tirar capturas de tela, analisar coordenadas de janelas, mover o cursor do mouse, clicar em botões e inserir texto sem o uso de APIs específicas.