Moonshot udostępnił K3.1 Pro z naciskiem na 3D tooling
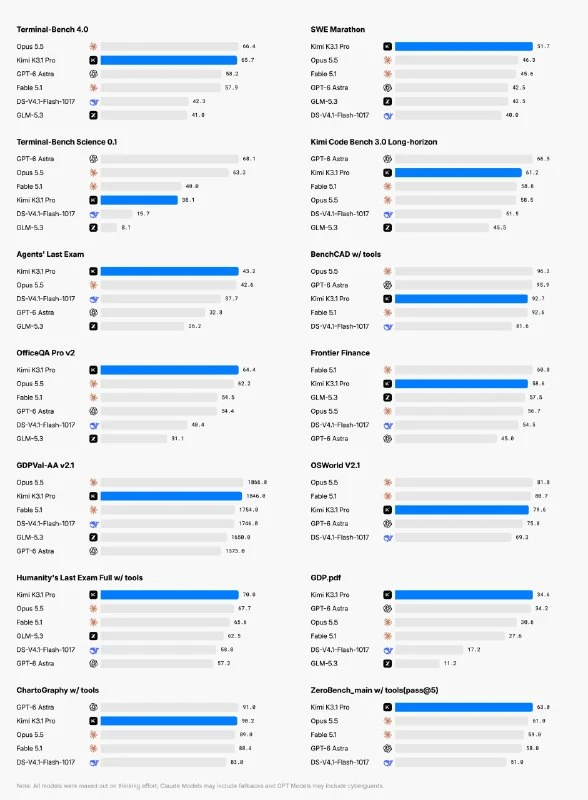
Moonshot AI udostępnił K3.1 Pro, model oparty na tej samej bazie co K3. W tym wydaniu szczególny nacisk położono na 3D tooling — zarówno Blender, jak i silniki gier, takie jak Unity, Unreal Engine i Godot.
Model jest już dostępny we wszystkich produktach Moonshot, a wagi modelu mają zostać udostępnione 4 listopada. Zapowiedź sugeruje również, że wkrótce może pojawić się mniejsza wersja, ponieważ inferencja modelu tej wielkości pozostaje trudna.
Dlaczego to ważne
AnalizaPremiera pokazuje, że modele AI coraz głębiej integrują się z pipeline'ami 3D i silnikami gier. Obiecane wagi modelu mogą dać programistom więcej możliwości lokalnych i niestandardowych wdrożeń.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami
Powiązane w ekosystemie
Praktyczne poradniki, kluczowa terminologia i skille agentów
Nowa Kimi została dostosowana do gamedevu i 3D
Kimi została dostosowana do Unity, Unreal Engine, Godot i generowania 3D oraz pokazała autonomiczny symulator chodu.
Kimi K3.1: model AI z 2,8 biliona parametrów
Kimi K3.1 jest przedstawiany jako bardzo duży model otwarty z 2,8 biliona parametrów i 104 miliardami parametrów aktywnych, ale jego wagi nie zostały jeszcze opublikowane.
Jev i System One AI: Kompletny praktyczny przewodnik po modelu decyzyjnym od TypeSafe
Głęboka analiza inżynieryjna flagowego modelu Jev: architektura System One w kontraście do LLM, prymitywy Choice/Score/Noul, równoległość zapytań, matematyka pewności, przypadki użycia wideo, kod oraz przegląd lokalnych alternatyw open-weight (Laya, GLiNER2.5, CLM-8B).
Przewodnik po Antigravity
Poradnik przeznaczony dla wszystkich entuzjastów ekosystemu Google AI, środowiska programistycznego Antigravity IDE/CLI oraz modeli z rodziny Gemini.
Protokół Agent-to-Agent (A2A)
Otwarty standard sieciowej interakcji, zdecentralizowanego wykrywania oraz bezpiecznej wymiany kontekstu między niezależnymi agentami AI pochodzącymi od różnych dostawców i działającymi na różnych platformach.
Benchmarki dla agentów: GAIA i SWE-bench
Nowe pokolenie rygorystycznych, praktycznych benchmarków służących do oceny autonomii sztucznej inteligencji. GAIA testuje zadania multimodalne w otwartym internecie z wykorzystaniem plików i przeglądarki, natomiast SWE-bench sprawdza zdolność agentów do znajdowania i naprawiania rzeczywistych błędów w dużych repozytoriach GitHub.