Moonshot выпустили K3.1 Pro с акцентом на 3D-тулинг
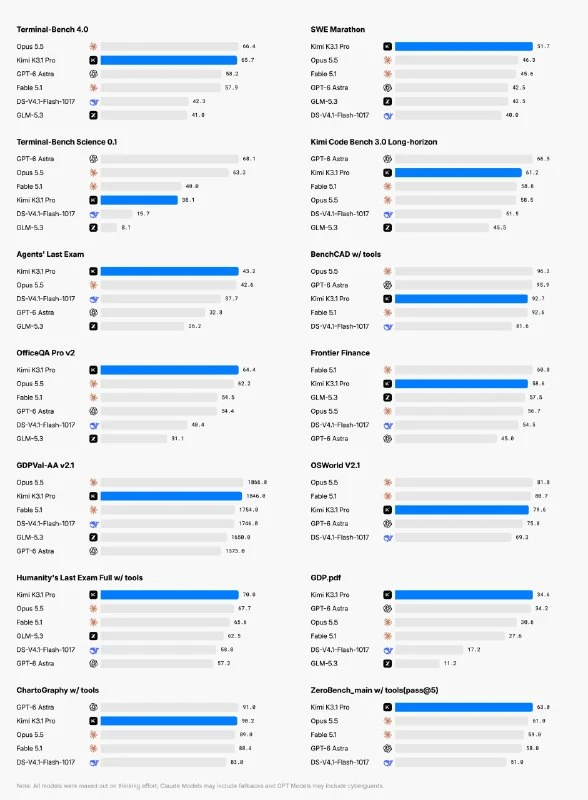
Moonshot AI выпустила модель K3.1 Pro на базе K3 с упором на 3D-тулинг и игровые движки; веса обещают опубликовать 4 ноября.
Moonshot выпустили K3.1 Pro
Она основана на той же базовой модели, что и K3, но, похоже, Moonshot сложно инференсить модель такого размера, и мы скоро увидим модельку поменьше. Особый упор в этом релизе делается на использовании 3D-тулинга — как Blender, так и игровых движков Unity, Unreal Engine и Godot. Модель уже релизнута во всех продуктах Moonshot, веса обещают 4 ноября.
Почему это важно
АналитикаРелиз показывает, как ИИ-модели всё глубже интегрируются в 3D-пайплайны и работу с игровыми движками. Обещанные открытые веса могут дать разработчикам больше возможностей для локального и кастомного использования.
Обсудить в сообществе
Делитесь опытом и мыслями с ИИ-разработчиками
Связанные материалы экосистемы
Практические гайды, терминология и агентские скиллы
Новая Kimi дообучалась с акцентом на геймдев и 3D
Модель Kimi дообучалась для работы с Unity, Unreal Engine, Godot и 3D-генерацией, а также продемонстрировала автономный кейс построения симулятора ходьбы.
Вышла Kimi K3.1: большая открытая модель с 2,8 трлн параметров
Kimi K3.1 позиционируется как очень большая открытая модель с 2,8 трлн параметров и 104 млрд активных параметров, но её веса пока не опубликованы.
Jev и System One AI: полное практическое руководство по модели решений от TypeSafe
Глубокий инженерный разбор флагманской модели Jev: архитектура System One против LLM, примитивы Choice/Score/Noul, параллелизм запросов, математика уверенности, видео-кейсы, код и обзор локальных open-weight альтернатив (Laya, GLiNER2.5, CLM-8B).
Я люблю Antigravity гайд
Гайд посвящается всем ценителям экосистемы Google AI, среды разработки Antigravity IDE/CLI и моделей семейства Gemini.
Протокол Межагентной Коммуникации (A2A)
Открытый стандарт сетевого взаимодействия, децентрализованного обнаружения и безопасного обмена контекстом между независимыми ИИ-агентами различных вендоров и платформ.
Бенчмарки для агентов: GAIA и SWE-bench
Новое поколение строгих практических бенчмарков для оценки автономности искусственного интеллекта. GAIA тестирует мультимодальные задачи в открытом вебе с файлами и браузером, а SWE-bench проверяет способность агентов находить и исправлять настоящие баги в больших репозиториях GitHub.