Moonshot представила K3.1 Pro з акцентом на 3D-тулінг
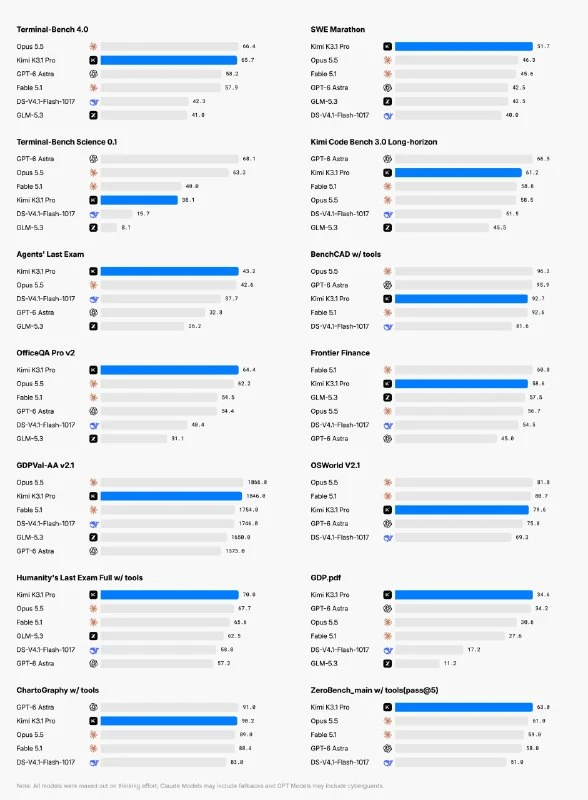
Moonshot AI випустила модель K3.1 Pro, орієнтовану на роботу з 3D-інструментами та ігровими рушіями, і анонсувала опублікування ваг 4 листопада.
Moonshot AI випустила модель K3.1 Pro, побудовану на тій самій базовій моделі, що й K3. Реліз робить особливий акцент на використанні 3D-тулінгу — зокрема Blender та ігрових рушіїв Unity, Unreal Engine і Godot.
Модель уже доступна в усіх продуктах Moonshot, а ваги моделі обіцяють опублікувати 4 листопада. Анонс також натякає, що невдовзі може з’явитися менша версія, оскільки інференс моделі такого розміру залишається складним.
Чому це важливо
АналітикаРеліз показує, як ШІ-моделі дедалі більше інтегруються у 3D-пайплайни та ігрові рушії. Обіцянка опублікувати ваги може відкрити розробникам доступ до локального та кастомного застосування.
Обговорити новину у спільноті
Діліться своїм досвідом та думками з ШІ-розробниками
Пов'язані матеріали екосистеми
Практичні гайди, термінологія та агентські скіли
ШІ-модель Kimi отримала дообучання з акцентом на геймдев і 3D
Модель Kimi дообучалась для роботи з Unity, Unreal Engine, Godot і 3D-генерацією, а також продемонструвала автономний кейс побудови симулятора ходьби.
Вийшла Kimi K3.1: велика ШІ-модель із 2,8 трлн параметрів
Kimi K3.1 заявлена як велика ШІ-модель із 2,8 трлн параметрів і 104 млрд активних параметрів; ваги ще не опубліковані, але їх обіцяють через кілька тижнів.
Jev та System One AI: повний практичний гайд по моделі рішень від TypeSafe
Глибокий інженерний розбір флагманської моделі Jev: архітектура System One проти LLM, примітиви Choice/Score/Noul, паралелізм запитів, математика впевненості, відео-кейси, код та огляд локальних open-weight альтернатив (Laya, GLiNER2.5, CLM-8B).
Я люблю Antigravity гайд
Гайд присвячується всім поціновувачам екосистеми Google AI, розробницького середовища Antigravity IDE/CLI та моделей сімейства Gemini.
Agent-to-Agent Protocol (A2A)
Відкритий стандарт мережевої взаємодії, децентралізованого виявлення та безпечного обміну контекстом між незалежними ШІ-агентами різних вендорів і платформ.
Бенчмарки для агентів: GAIA та SWE-bench
Нове покоління суворих практичних бенчмарків для оцінки автономності штучного інтелекту. GAIA тестує мультимодальні завдання у відкритому вебі з файлами та браузером, а SWE-bench перевіряє здатність агентів знаходити та виправляти справжні баги у великих репозиторіях GitHub.