Kimi K3.1 Pro oficjalnie zaprezentowana: 3 biliony parametrów i kontekst 1 miliona tokenów
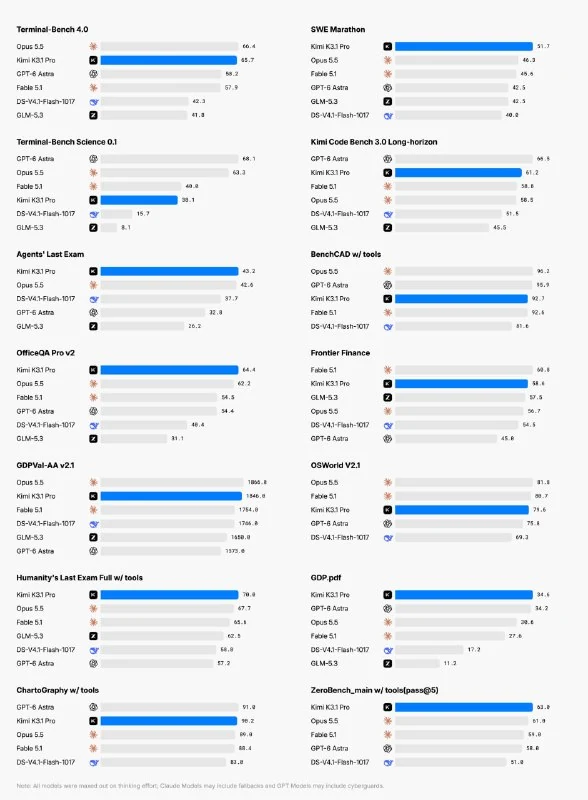
Kimi zaprezentowało pierwszy model rodziny K3.1, z 3 bilionami parametrów i oknem kontekstu 1 miliona tokenów; pełne wagi mają zostać opublikowane 4 listopada.
Kimi K3.1 Pro została oficjalnie zaprezentowana.
Zespół wydał pierwszy model rodziny K3.1, a wyniki wyglądają obiecująco.
- Model z 3 bilionami parametrów i oknem kontekstu 1 miliona tokenów.
- Przewyższa Astra i Fable 5.1 przy znacznie niższym koszcie.
- Uzyskała 65,7% w Terminal-Bench 4.0.
- Pełne wagi modelu zostaną opublikowane 4 listopada.
Model jest już dostępny w Kimi, Kimi Work, Kimi Code oraz przez API.
Kimi wraca do gry.
Dlaczego to ważne
AnalizaJeśli zapowiedziane parametry się potwierdzą, model może być silną alternatywą cenową i wydajnościową dla zadań agentowych i programistycznych. Publikacja wag umożliwi niezależną ocenę i wdrożenie.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami
Powiązane w ekosystemie
Praktyczne poradniki, kluczowa terminologia i skille agentów
Kimi K3.1: model AI z 2,8 biliona parametrów
Kimi K3.1 jest przedstawiany jako bardzo duży model otwarty z 2,8 biliona parametrów i 104 miliardami parametrów aktywnych, ale jego wagi nie zostały jeszcze opublikowane.
Kimi K3.1: zapowiedź nowego modelu od zespołu Kimi
Zespół Kimi opublikował zapowiedź sugerującą rychłe pojawienie się modelu Kimi K3.1, który ma być najlepszy spośród dostępnych chińskich modeli AI i znacznie tańszy w użyciu niż Kimi K3.
Część I. Architektura agentów AI: fundamentalne elementy
Dziesięć fundamentalnych elementów współczesnego agenta: taksonomia modeli, pętla runtime, techniki promptowania, destylacja, umiejętności (skills), pamięć, wywoływanie funkcji oraz ekonomia jednostkowa.
Część II. Architektura agentów AI: od modelu do pamięci i narzędzi
Głęboka analiza inżynierska: tokenizacja, cache KV, determinizm próbkowania, stos treningowy, kwantyzacja, inżynieria kontekstu, stos bezpieczeństwa, produkcyjny RAG, ReAct oraz systemy multiagentowe typu swarm.
DeepSeek (Chiński przełom w otwartym AI)
Seria przełomowych modeli open-source od chińskiego laboratorium DeepSeek (V3, R1). Prezentuje najwyższy poziom w kodowaniu i rozumowaniu przy kosztach 10–20 razy niższych niż zachodnie odpowiedniki komercyjne.
DeepSeek-R1 (Model rozumowania DeepSeek)
Przełomowy otwarty model rozumowania (Open Weights Reasoning Model) oparty na architekturze MoE o rozmiarze 671B, który udowodnił możliwość kształtowania niezwykle złożonego myślenia logicznego poprzez czyste uczenie ze wzmocnieniem (GRPO).