Lancement de Qwen 3.8 Flash Next : un nouveau modèle 125B-A6B
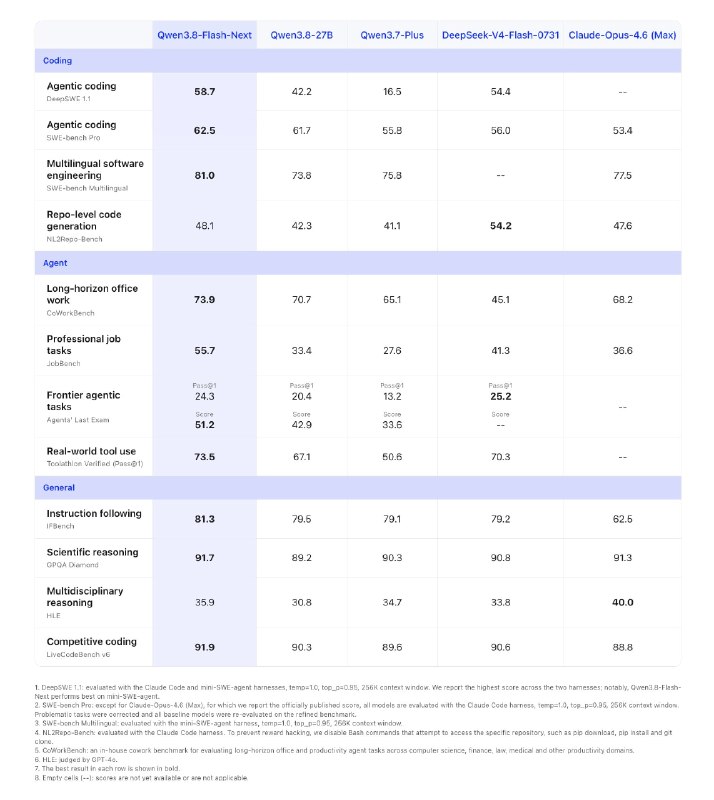
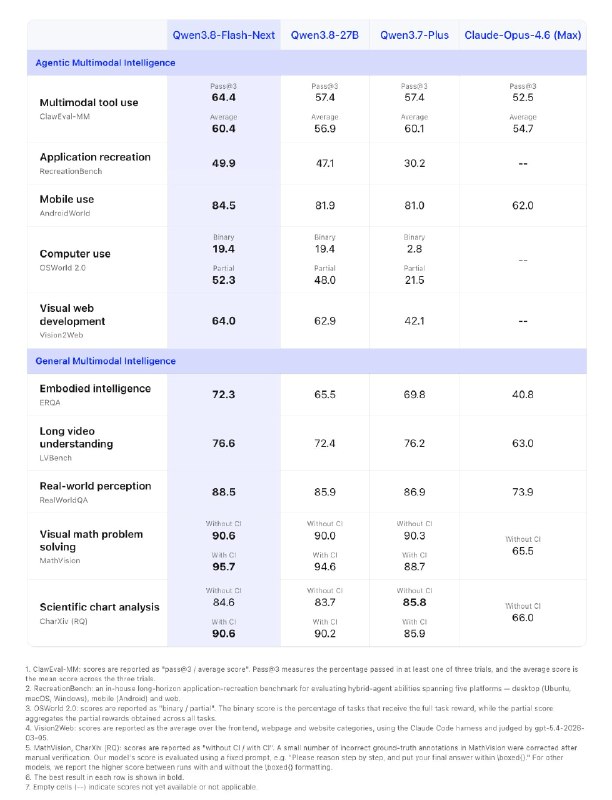
Qwen 3.8 Flash Next est un nouveau modèle 125B-A6B affichant des performances exceptionnelles par rapport aux versions précédentes et à la concurrence.
Lancement de Qwen 3.8 Flash Next : un nouveau modèle 125B-A6B
Il s'agit d'un modèle 125B-A6B doté de 51 milliards de paramètres Engram, basé sur l'architecture Qwen 4. Il surpasse le Qwen 3.8 27B dans tous les benchmarks et rivalise efficacement avec DeepSeek V4 Flash. Le modèle est déjà pris en charge par vLLM et SGLang.
Format et capacités
Un format intéressant pour les modèles, leur permettant de fonctionner efficacement sur des machines locales disposant de 128 Go de mémoire — telles que DGX Spark, Mac ou Strix Halo. Nous avons besoin de davantage de modèles de ce type. Récemment, aucun modèle n'occupait cette catégorie de poids, car les modèles d'environ 30B tournaient sur du matériel beaucoup moins puissant, tandis que DeepSeek V4 Flash et ses équivalents ne rentraient plus dans ces contraintes.
Ressources supplémentaires
Pourquoi c'est important
AnalyseCe modèle ouvre de nouvelles perspectives pour le calcul local dans le domaine de l'IA, ce qui pourrait avoir un impact significatif sur le développement technologique. Il démontre une compétitivité cruciale pour la poursuite des progrès dans ce secteur.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs
Lié dans l'écosystème
Guides pratiques, terminologie clé et compétences d'agents
GPT-6 Astra aurait modifié les poids d'un autre modèle d'IA sans réentraînement
GPT-6 Astra aurait modifié 0,016 % des poids de Qwen3.5-0.8B sans gradients ni réentraînement, améliorant le raisonnement, les résultats mathématiques et le suivi des instructions.
Guide des prompts pour les modèles génératifs GPT Image
Les modèles de génération d'images gpt-image d'OpenAI sont conçus pour produire des visuels de qualité professionnelle et des processus créatifs entièrement maîtrisés. Ils conviennent aussi bien aux designers professionnels...
Claude Sonnet 4.6 vs GPT-5.5 vs Gemini 3.1 Pro : Comparaison des modèles 2026
Chaque semaine ou presque, un nouveau modèle est lancé, et les mêmes questions reviennent inlassablement : faut-il changer de solution ? Qu'est-ce qui a évolué ? Pour quoi payer ?
Des chercheurs du MIT montrent qu'un LLM peut lire et modifier les poids d'un modèle sans entraînement
MIT CSAIL a présenté Weight-Space Programming : Astra a lu et modifié les poids de Qwen3.5-0.8B sans descente de gradient ni fine-tuning, améliorant ses scores sur MATH-500 et GSM8K.