GPT-6 Astra aurait modifié les poids d'un autre modèle d'IA sans réentraînement
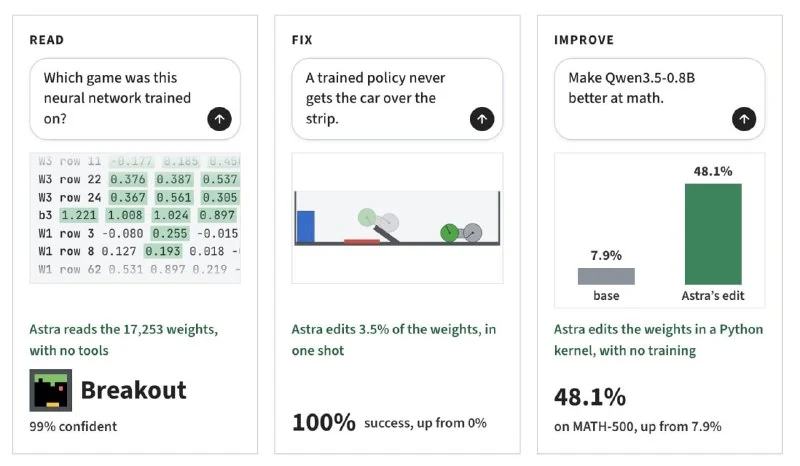
GPT-6 Astra aurait modifié 0,016 % des poids de Qwen3.5-0.8B sans gradients ni réentraînement, améliorant le raisonnement, les résultats mathématiques et le suivi des instructions.
GPT-6 Astra aurait modifié les poids d'un autre modèle d'IA sans réentraînement
Selon certaines affirmations, GPT-6 Astra a pu modifier directement les paramètres internes d'un autre réseau neuronal sans calculer de gradients ni effectuer d'entraînement supplémentaire.
En modifiant seulement 0,016 % des poids de Qwen3.5-0.8B, Astra aurait:
- éliminé les boucles de raisonnement ;
- amélioré les résultats en mathématiques jusqu'à six fois ;
- triplé la capacité à suivre les instructions.
Cela suggère que l'IA pourrait commencer à corriger d'autres modèles d'IA de l'intérieur.
Pourquoi c'est important
AnalyseSi confirmé, le weight-space programming pourrait réduire le besoin de fine-tuning et permettre l'auto-correction des modèles d'IA.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs
Lié dans l'écosystème
Guides pratiques, terminologie clé et compétences d'agents
Partie II. Architecture des agents IA : du modèle à la mémoire et aux outils
Immersion technique approfondie : tokenisation, cache KV, déterminisme de l'échantillonnage, stack d'entraînement, quantification, ingénierie contextuelle, stack de sécurité, RAG en production, ReAct et systèmes swarm multi-agents.
Guide des prompts pour les modèles génératifs GPT Image
Les modèles de génération d'images gpt-image d'OpenAI sont conçus pour produire des visuels de qualité professionnelle et des processus créatifs entièrement maîtrisés. Ils conviennent aussi bien aux designers professionnels...
Modèles de pointe (Frontier Models)
La classe d'intelligence artificielle la plus puissante à l'avant-garde de la recherche mondiale (Claude 3.7 Sonnet, OpenAI o3/GPT-4.5, Gemini 2.0 Pro), définissant les limites actuelles des capacités de raisonnement, d'autonomie et de codage.
LLM (Large Language Model - Grand modèle de langage)
Classe fondamentale d'architectures de réseaux neuronaux basée sur le transformateur autorégressif, qui prédit la distribution probabiliste des tokens suivants et démontre des propriétés émergentes de pensée abstraite, de synthèse de code et de raisonnement logique.