Premiera Qwen 3.8 Flash Next: Nowy model 125B-A6B
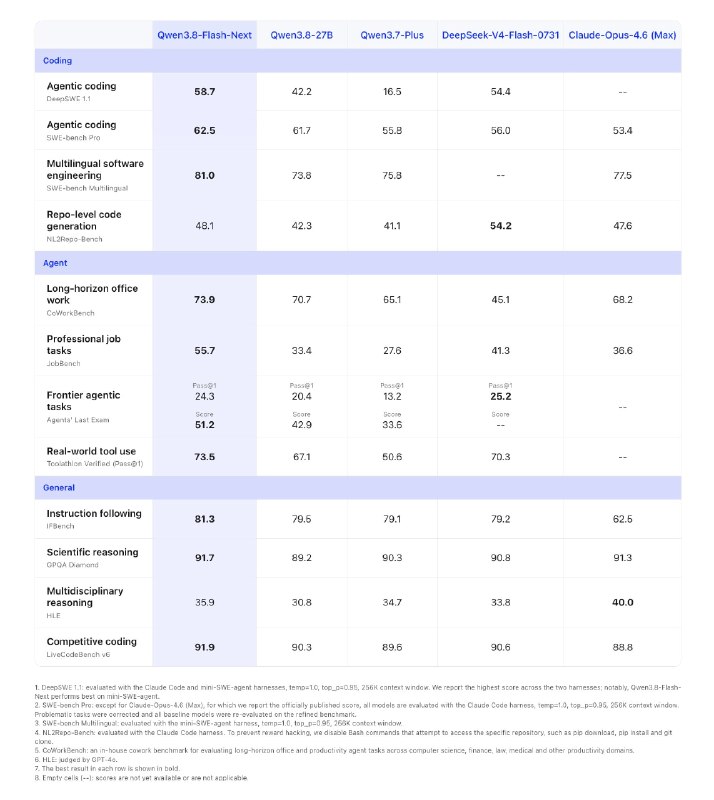
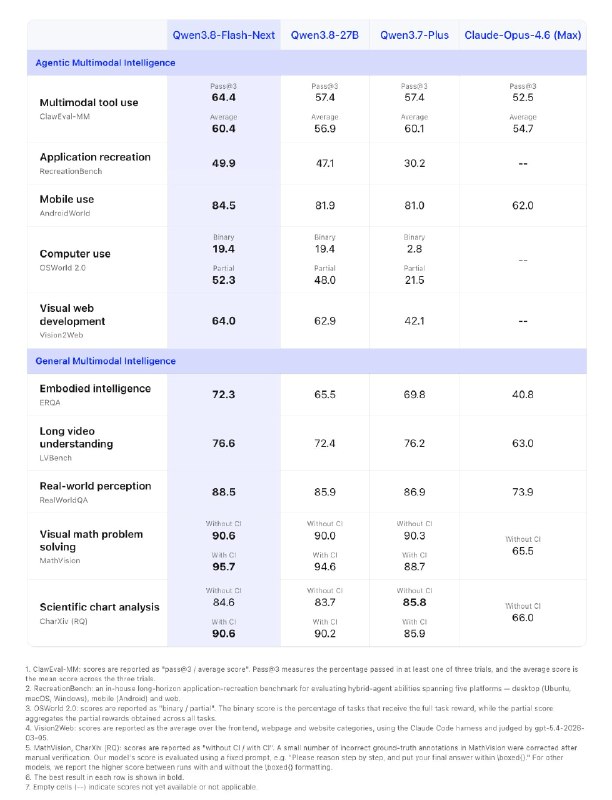
Qwen 3.8 Flash Next to nowy model o architekturze 125B-A6B, który oferuje doskonałe wyniki w porównaniu z poprzednimi wersjami i konkurencją.
Premiera Qwen 3.8 Flash Next: Nowy model 125B-A6B
Jest to model o parametrach 125B-A6B, zawierający 51 mld parametrów Engram, oparty na architekturze Qwen 4. Przewyższa on Qwen 3.8 27B we wszystkich benchmarkach i bardzo dobrze konkurowuje z DeepSeek V4 Flash. Model jest już wspierany przez vLLM oraz SGLang.
Forma i możliwości
Ciekawy format modelu pozwala na jego efektywne uruchamianie na lokalnych maszynach z pamięcią 128 GB – takich jak DGX Spark, Mac czy Strix Halo. Potrzebujemy więcej modeli tego typu. Ostatnio brakowało rozwiązań w tej kategorii wagowej, ponieważ modele ~30B działały na znacznie słabszym sprzęcie, podczas gdy DeepSeek V4 Flash i podobne modele przestały się mieścić w tych limitach.
Dodatkowe zasoby
Dlaczego to ważne
AnalizaTen model otwiera nowe możliwości dla obliczeń lokalnych w dziedzinie AI, co może znacząco wpłynąć na rozwój technologii. Demonstruje on wysoką konkurencyjność rynkową, która jest kluczowa dla dalszego postępu w tym obszarze.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami
Powiązane w ekosystemie
Praktyczne poradniki, kluczowa terminologia i skille agentów
GPT-6 Astra miała zmienić wagi innego modelu AI bez doszkalania
GPT-6 Astra miała zmienić tylko 0,016% wag Qwen3.5-0.8B bez gradientów i doszkalania, poprawiając rozumowanie, wyniki matematyczne i stosowanie się do instrukcji.
Przewodnik po promptach dla modeli generatywnych GPT Image
Modele generowania obrazów gpt-image od OpenAI zostały zaprojektowane w celu tworzenia wizualizacji o jakości produkcyjnej oraz umożliwienia pełnej kontroli nad procesami twórczymi. Są one odpowiednie zarówno dla profesjonalnych projektantów...
Claude Sonnet 4.6 vs GPT-5.5 vs Gemini 3.1 Pro: porównanie modeli na rok 2026
Co kilka tygodni pojawia się nowy model, a za każdym razem padają te same pytania: czy warto przejść? Co się zmieniło? Za co płacić?
Badacze z MIT pokazali, że LLM może czytać i edytować wagi modeli bez uczenia
MIT CSAIL zaprezentował Weight-Space Programming: Astra czytała i modyfikowała wagi Qwen3.5-0.8B bez gradientowego spadku i fine-tuningu, poprawiając wyniki w benchmarkach matematycznych.