Se lanzó Qwen 3.8 Flash Next — un nuevo modelo de 125B-A6B
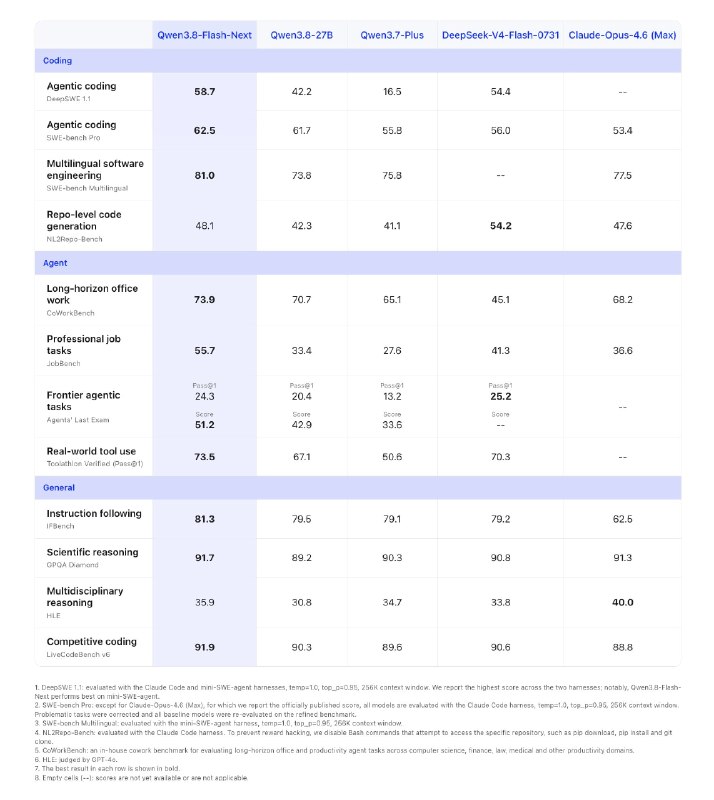
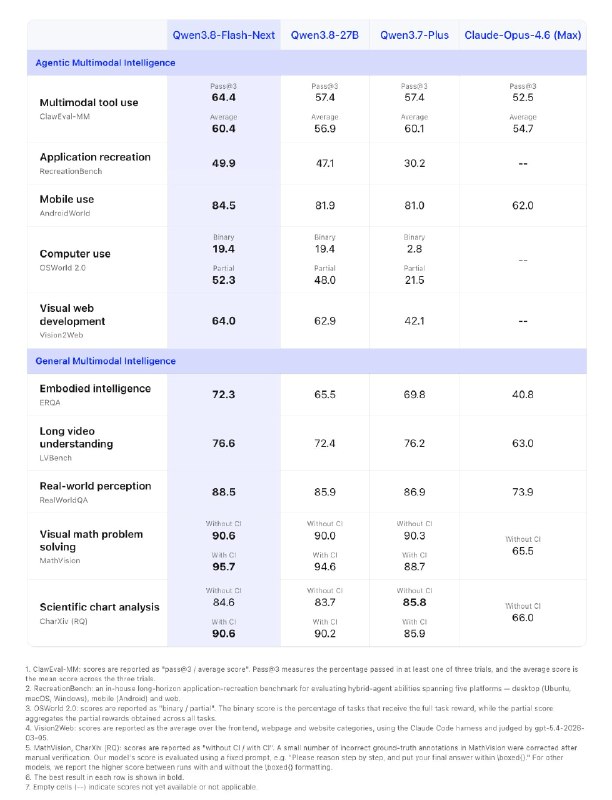
Qwen 3.8 Flash Next es un nuevo modelo de 125B-A6B que muestra un excelente rendimiento en comparación con versiones anteriores y competidores.
Se lanzó Qwen 3.8 Flash Next — un nuevo modelo de 125B-A6B
Este es un modelo 125B-A6B con 51B de parámetros Engram basado en la arquitectura Qwen 4. Supera a Qwen 3.8 27B en todas las pruebas y compite muy bien con DeepSeek V4 Flash. El modelo ya es compatible con vLLM y SGLang.
Formato y capacidades
Un formato interesante para modelos que permite ejecutarlos de manera eficiente en máquinas locales con 128GB de memoria — DGX Spark, Mac, Strix Halo. Necesitamos más modelos como este. Recientemente, no ha habido modelos en esta categoría de peso, ya que los modelos de ~30B se ejecutaban en hardware mucho más débil, mientras que DeepSeek V4 Flash y modelos similares ya no cabían.
Recursos adicionales
Por qué es importante
AnálisisEste modelo abre nuevas posibilidades para la computación local en el campo de la IA, lo que puede tener un impacto significativo en el desarrollo tecnológico. Demuestra competitividad en el mercado, lo cual es crucial para el progreso futuro en esta área.
Debatir en la comunidad
Comparte tus preguntas e ideas con desarrolladores
Relacionado en el ecosistema
Guías prácticas, terminología y skills de agentes
GPT-6 Astra habría modificado pesos de otro modelo de IA sin reentrenamiento
Se afirma que GPT-6 Astra modificó solo el 0,016% de los pesos de Qwen3.5-0.8B sin gradientes ni reentrenamiento, mejorando razonamiento, matemáticas y seguimiento de instrucciones.
Guía de prompts para los modelos generativos GPT Image
Los modelos de generación de imágenes gpt-image de OpenAI están diseñados para obtener visuales de calidad de producción y procesos creativos totalmente controlables. Son adecuados...
Claude Sonnet 4.6 vs GPT-5.5 vs Gemini 3.1 Pro: comparación de modelos 2026
Cada pocas semanas sale un nuevo modelo y cada vez surgen las mismas preguntas: ¿debería cambiar? ¿Qué cambió por qué pagar?
Investigadores del MIT muestran que un LLM puede leer y editar pesos de modelos sin entrenamiento
El equipo de MIT CSAIL presentó Weight-Space Programming: Astra leyó y modificó los pesos de Qwen3.5-0.8B sin descenso de gradiente ni fine-tuning, mejorando sus resultados en benchmarks matemáticos.