Cerebras начнёт хостить Qwen 3.8 27B с 3 сентября
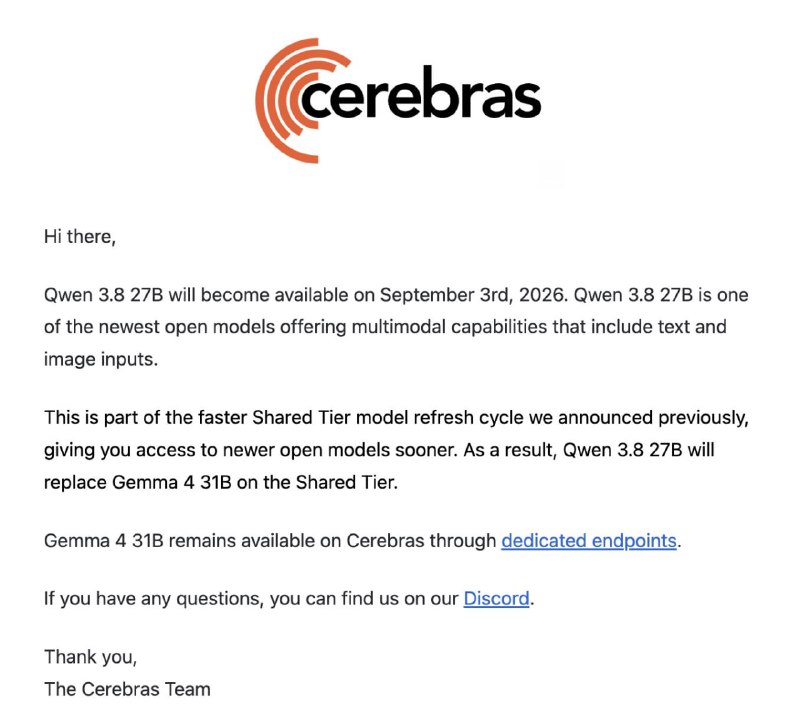
Cerebras анонсировала запуск хостинга Qwen 3.8 27B, который начнётся 3 сентября, с потенциальной скоростью обработки 2000+ токенов в секунду.
Cerebras начнёт хостить Qwen 3.8 27B с 3 сентября.
На Cerebras она, скорее всего, будет работать на скорости 2000+ токенов в секунду. Это в 10 раз быстрее, чем быстрый режим Codex, который выдает примерно 150–200 токенов в секунду.
Для сравнения, ChatGPT обычно выдает около 50–100 токенов в секунду. Таким образом, Qwen на Cerebras потенциально сможет работать примерно в 10 раз быстрее, чем быстрый режим Codex.
Почему это важно
АналитикаЭто важно, поскольку скорость обработки токенов может значительно повлиять на эффективность использования AI-моделей в реальных приложениях. Запуск Qwen на Cerebras открывает новые возможности для более быстрой обработки данных.
Обсудить в сообществе
Делитесь опытом и мыслями с ИИ-разработчиками
Связанные материалы экосистемы
Практические гайды, терминология и агентские скиллы
GPT-6 без дообучения улучшила веса Qwen3.5-0.8B
Исследователи MIT CSAIL показали Weight-Space Programming: Astra без градиентного спуска и обучения изменила веса Qwen3.5-0.8B и улучшила её результаты на MATH-500 и GSM8K.
JSON — структурированные данные для программ, API и AI-агентов
Полное практическое руководство по формату JSON: синтаксические правила, сериализация через parse/stringify, работа с REST API, валидация по JSON Schema и структурированный вывод для ИИ.
Форматы DOCX и XLSX: когда от ИИ требуется полноценный финальный документ
Практическое руководство по созданию и обработке документов DOCX и таблиц XLSX с помощью ИИ: сравнение с Markdown и CSV, промпт-инжиниринг, работа с формулами и автоматизация в коде.
Binance опубликовали расследование кражи $6,3 млрд
Расследование связывает кражу с заражённым Homebrew, фальшивым собеседованием и использованием внутреннего ИИ-инструмента Binance.