Cerebras hostet Qwen 3.8 27B ab dem 3. September
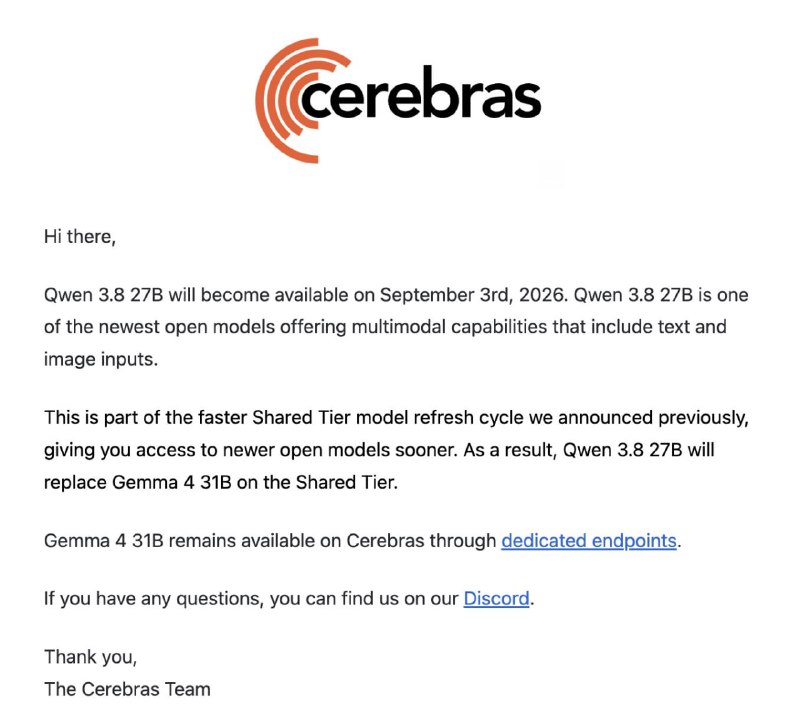
Cerebras kündigt die Bereitstellung von Qwen 3.8 27B an, mit einer erwarteten Verarbeitungsgeschwindigkeit von über 2.000 Tokens pro Sekunde.
Cerebras wird am 3. September mit der Bereitstellung von Qwen 3.8 27B beginnen.
Auf der Cerebras-Infrastruktur soll das Modell mit einer Geschwindigkeit von über 2.000 Tokens pro Sekunde laufen. Dies stellt eine erhebliche Steigerung im Vergleich zu ChatGPT dar, das typischerweise etwa 50–100 Tokens pro Sekunde ausgibt, sowie zum schnellen Modus von Codex, der bei rund 150–200 Tokens liegt.
Somit könnte Qwen auf Cerebras potenziell ungefähr zehnmal schneller arbeiten als der schnelle Modus von Codex.
Warum das wichtig ist
AnalyseDie Geschwindigkeit der Token-Verarbeitung ist ein entscheidender Faktor für die Effizienz von KI-Modellen in Echtzeitanwendungen. Der Start von Qwen auf Cerebras eröffnet neue Möglichkeiten für deutlich schnellere Datenverarbeitung.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern
Verwandt im Ökosystem
Praktische Leitfäden, Terminologie und Agenten-Skills
JSON – strukturierte Daten für Anwendungen, APIs und KI-Agenten
Ein umfassender praktischer Leitfaden zum JSON-Format: Syntaxregeln, Serialisierung über parse/stringify, Arbeit mit REST-APIs, JSON Schema und strukturierter Output für künstliche Intelligenz.
DOCX- und XLSX-Formate: Wann ein vollwertiges finales Dokument von KI erforderlich ist
Ein umfassender praktischer Leitfaden zur Generierung und Verarbeitung von DOCX-Dokumenten und XLSX-Tabellen mit KI: Vergleich mit Markdown und CSV, Prompt-Engineering, Arbeit mit Formeln und Automatisierung im Code.
Binance veröffentlicht Untersuchung zum Diebstahl von 6,3 Mrd. US-Dollar
Die Untersuchung verbindet den Diebstahl mit einem manipulierten Homebrew, einem gefälschten Interview und dem Missbrauch eines internen KI-Tools von Binance.
Reddit-Nutzer erklärt, warum Claude-Code-Wochenlimits fast viermal schneller verbraucht werden
Ein Reddit-Nutzer verglich den Token-Verbrauch über zwei Wochen und stellte fest, dass auf jedes 1 % des Wochenlimits von Claude Code deutlich weniger Ausgabe-Tokens entfallen; Subagents, Reasoning-Dauer und UI-Aktualisierungen gelten als mögliche Ursachen.