Apple Silicon: Die ideale Architektur für Large Language Models
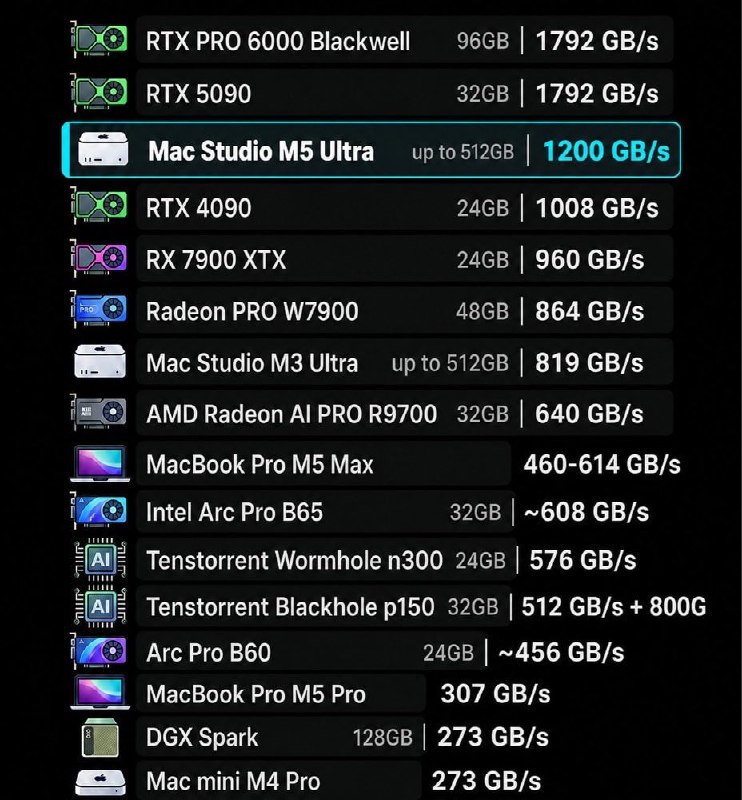
Die Apple-Silicon-Architektur erweist sich dank hoher Bandbreite und Unified Memory als nahezu perfekt für den lokalen Betrieb großer Sprachmodelle. Der Mac Studio M5 Ultra schlägt dabei herkömmliche PC-Cluster deutlich.
Apple Silicon: Die ideale Architektur für Large Language Models
Die Apple-Silicon-Architektur hat sich als nahezu ideal für den Betrieb von Large Language Models (LLMs) erwiesen. Dies ist vor allem der Kombination aus schnellem Speicher, hoher Bandbreite und einer Unified-Memory-Architektur zu verdanken.
Der Mac Studio M5 Ultra mit 512 GB Arbeitsspeicher und einer Bandbreite von 1,2 TB/s kann das Modell GLM-5.3-Flash mit 320 Milliarden Parametern im FP8-Format vollständig aufnehmen. Dabei liefert er lokal auf dem Desktop eine Geschwindigkeit von rund 60 Tokens pro Sekunde.
Alternative auf dem PC?
Man benötigt etwa 10 RTX 5090-Grafikkarten, die zusammen über 20.000 US-Dollar kosten, sowie eine eigene kleine Stromversorgung.
Die Vollversion von GLM-5.3-Flash mit 320 Milliarden Parametern im FP8-Format wiegt etwa 306 GB. Eine einzelne RTX 5090 verfügt jedoch nur über 32 GB Videospeicher. Um die Modellgewichte zu speichern, sind daher mindestens 10 Grafikkarten erforderlich:
10 × 32 GB = 320 GB.
Der Mac Studio löst dieses Problem durch einen Unified-Memory-Pool von bis zu 512 GB bei einer Bandbreite von 1,2 TB/s. Anstatt einen PC-Cluster aus mehreren Grafikkarten aufzubauen, sich mit PCIe-Bus-Latenzen herumzuärgern und einen Stromverbrauch von rund 5.000 Watt in Kauf zu nehmen, lässt sich das gesamte 306-GB-Modell samt großem Kontext und KV-Cache auf einem einzigen Desktop-Computer laden.
Warum das wichtig ist
AnalyseDiese Entwicklung zeigt, wie neue Hardware-Architekturen die Ansätze zum Betrieb von LLMs grundlegend verändern können. Sie macht leistungsstarke KI-Modelle für Entwickler zugänglicher und effizienter.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern