Apple Silicon: A Arquitetura Ideal para Grandes Modelos de Linguagem
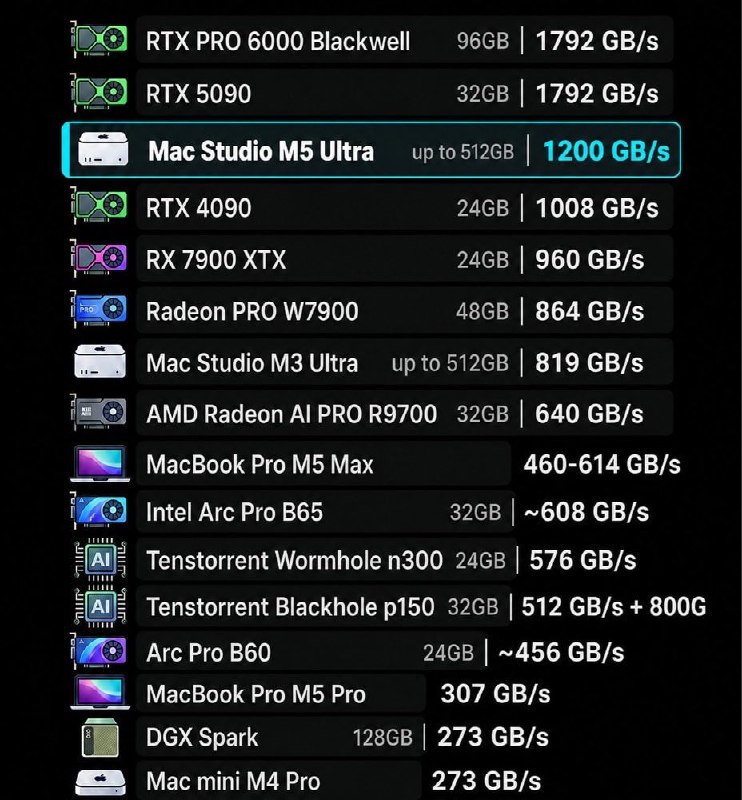
A arquitetura Apple Silicon demonstra ser ideal para a execução de grandes modelos de linguagem (LLMs), oferecendo velocidade e largura de banda superiores. O Mac Studio M5 Ultra destaca-se ao rodar modelos massivos localmente, superando as limitações de clusters de GPUs tradicionais.
Apple Silicon: A Arquitetura Ideal para Grandes Modelos de Linguagem
A arquitetura Apple Silicon revelou-se quase perfeita para a execução de grandes modelos de linguagem. Isso se deve à combinação de memória rápida, alta largura de banda e uma arquitetura de memória unificada.
O Mac Studio M5 Ultra, equipado com 512 GB de memória e uma largura de banda de 1,2 TB/s, é capaz de acomodar completamente o modelo GLM-5.3-Flash, que possui 320 bilhões de parâmetros em FP8, entregando cerca de 60 tokens por segundo localmente, diretamente no desktop.
Alternativa em PC?
Seriam necessários aproximadamente 10 placas RTX 5090, custando mais de US$ 20.000, além de uma pequena usina de energia própria.
A versão completa do GLM-5.3-Flash, com 320 bilhões de parâmetros em FP8, pesa cerca de 306 GB. Uma única RTX 5090 possui apenas 32 GB de memória de vídeo. Portanto, para armazenar os pesos do modelo, são necessárias pelo menos 10 placas gráficas.
10 × 32 GB = 320 GB.
O Mac Studio resolve esse problema com um pool de memória unificada de até 512 GB e largura de banda de 1,2 TB/s. Em vez de construir um cluster de PC com múltiplas placas gráficas, lidando com latência do barramento PCIe e consumo de energia em torno de 5.000 W, é possível carregar o modelo inteiro de 306 GB, junto com um contexto enorme e cache KV, em um único computador desktop.
Por que isso importa
AnáliseEsta evolução é crucial pois demonstra como novas arquiteturas podem transformar as abordagens para executar grandes modelos de linguagem, tornando-os mais acessíveis e viáveis para desenvolvedores individuais.
Debater na comunidade
Compartilhe suas dúvidas e insights com desenvolvedores