Apple Silicon: Idealna architektura dla dużych modeli językowych
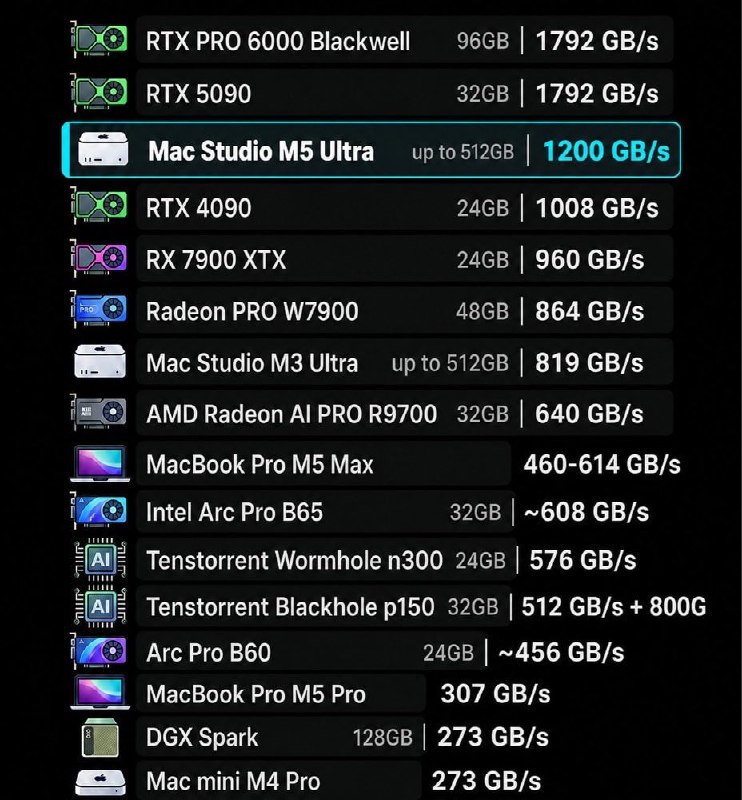
Architektura Apple Silicon udowodniła swoją skuteczność w uruchamianiu dużych modeli językowych dzięki połączeniu wysokiej przepustowości i zunifikowanej pamięci. Pozwala to na lokalne działanie zaawansowanych LLM bez konieczności budowania kosztownych klastrów GPU.
Apple Silicon: Idealna architektura dla dużych modeli językowych
Architektura Apple Silicon okazała się niemal doskonałym rozwiązaniem do uruchamiania dużych modeli językowych (LLM). Kluczem do sukcesu jest unikalne połączenie szybkiej pamięci, wysokiej przepustowości oraz zunifikowanej struktury pamięciowej.
Mac Studio M5 Ultra wyposażony w 512 GB pamięci i przepustowość rzędu 1,2 TB/s jest w stanie w pełni pomieścić model GLM-5.3-Flash o 320 miliardach parametrów w formacie FP8. Urządzenie to osiąga wydajność około 60 tokenów na sekundę, działając całkowicie lokalnie, bezpośrednio na stacji roboczej.
Alternatywa dla PC?
Odpowiednikiem byłoby około 10 kart graficznych RTX 5090, co wiąże się z wydatkiem przekraczającym 20 000 dolarów oraz koniecznością posiadania własnej, niewielkiej elektrowni.
Pełna wersja modelu GLM-5.3-Flash z 320 miliardami parametrów w precyzji FP8 zajmuje około 306 GB przestrzeni dyskowej/pamięciowej. Jedna karta RTX 5090 posiada jedynie 32 GB pamięci wideo. Oznacza to, że do przechowywania wag modelu niezbędnych jest co najmniej 10 takich kart:
10 × 32 GB = 320 GB.
Mac Studio rozwiązuje ten problem dzięki puli zunifikowanej pamięci o pojemności do 512 GB i przepustowości 1,2 TB/s. Zamiast budować klaster PC składający się z wielu kart graficznych, borykać się z opóźnieniami magistrali PCIe oraz poborem mocy rzędu 5000 W, użytkownik może załadować cały model o wielkości 306 GB wraz z ogromnym kontekstem i buforem KV do pojedynczego komputera stacjonarnego.
Dlaczego to ważne
AnalizaZjawisko to ilustruje, jak nowe podejścia architektoniczne rewolucjonizują sposób uruchamiania LLM, znacząco obniżając próg wejścia dla deweloperów. Umożliwia to efektywną pracę z zaawansowanymi modelami AI na standardowym sprzęcie desktopowym, eliminując potrzebę skomplikowanych infrastruktur serwerowych.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami