Cerebras hostet Qwen 3.8 27B ab dem 3. September
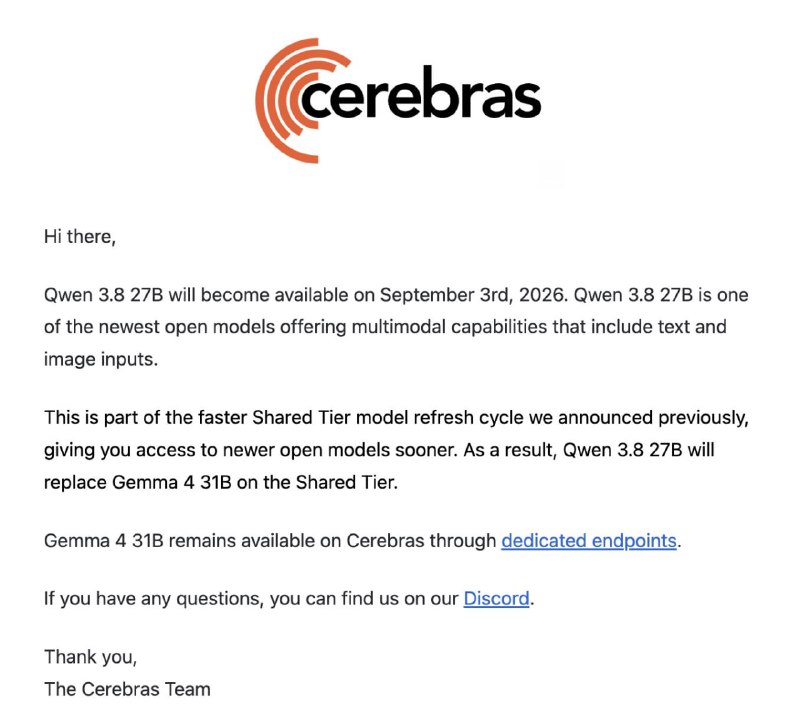
Cerebras kündigt die Bereitstellung von Qwen 3.8 27B an, mit einer erwarteten Verarbeitungsgeschwindigkeit von über 2.000 Tokens pro Sekunde.
Cerebras wird am 3. September mit der Bereitstellung von Qwen 3.8 27B beginnen.
Auf der Cerebras-Infrastruktur soll das Modell mit einer Geschwindigkeit von über 2.000 Tokens pro Sekunde laufen. Dies stellt eine erhebliche Steigerung im Vergleich zu ChatGPT dar, das typischerweise etwa 50–100 Tokens pro Sekunde ausgibt, sowie zum schnellen Modus von Codex, der bei rund 150–200 Tokens liegt.
Somit könnte Qwen auf Cerebras potenziell ungefähr zehnmal schneller arbeiten als der schnelle Modus von Codex.
Warum das wichtig ist
AnalyseDie Geschwindigkeit der Token-Verarbeitung ist ein entscheidender Faktor für die Effizienz von KI-Modellen in Echtzeitanwendungen. Der Start von Qwen auf Cerebras eröffnet neue Möglichkeiten für deutlich schnellere Datenverarbeitung.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern