Cerebras héberge Qwen 3.8 27B dès le 3 septembre
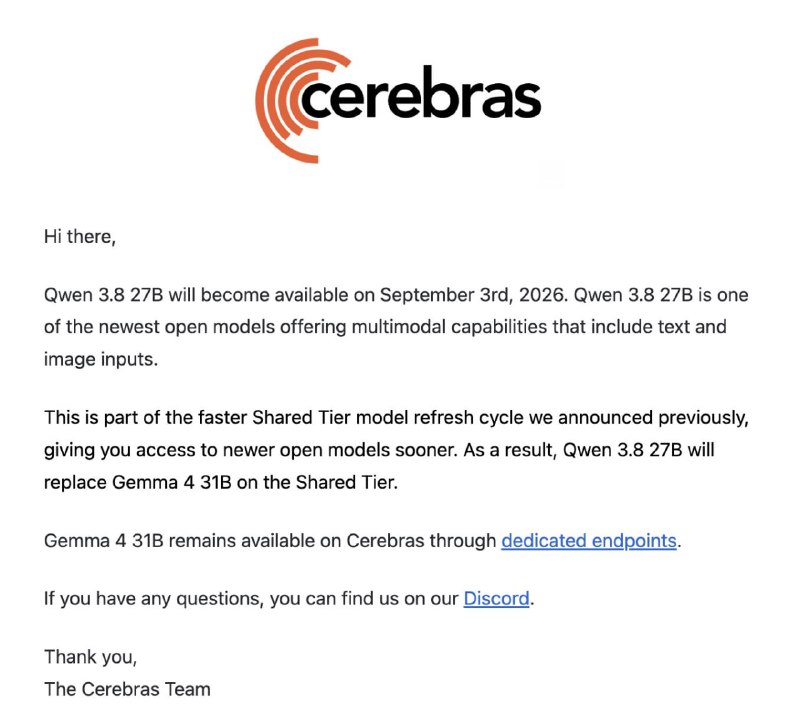
Cerebras annonce l'hébergement du modèle Qwen 3.8 27B à partir du 3 septembre, promettant une vitesse de traitement dépassant les 2000 tokens par seconde.
Cerebras débutera l'hébergement de Qwen 3.8 27B le 3 septembre.
Sur la plateforme Cerebras, le modèle devrait fonctionner à une vitesse supérieure à 2000 tokens par seconde. Il s'agit d'une augmentation significative par rapport à ChatGPT, qui génère généralement entre 50 et 100 tokens par seconde, et au mode rapide de Codex, situé autour de 150 à 200 tokens.
Ainsi, Qwen sur Cerebras pourrait potentiellement fonctionner environ dix fois plus vite que le mode rapide de Codex.
Pourquoi c'est important
AnalyseLa vitesse de traitement des tokens est un facteur critique pour l'efficacité des modèles d'IA dans les applications réelles. Le lancement de Qwen sur Cerebras ouvre la voie à un traitement des données beaucoup plus rapide.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs