Cerebras comenzará a alojar Qwen 3.8 27B a partir del 3 de septiembre
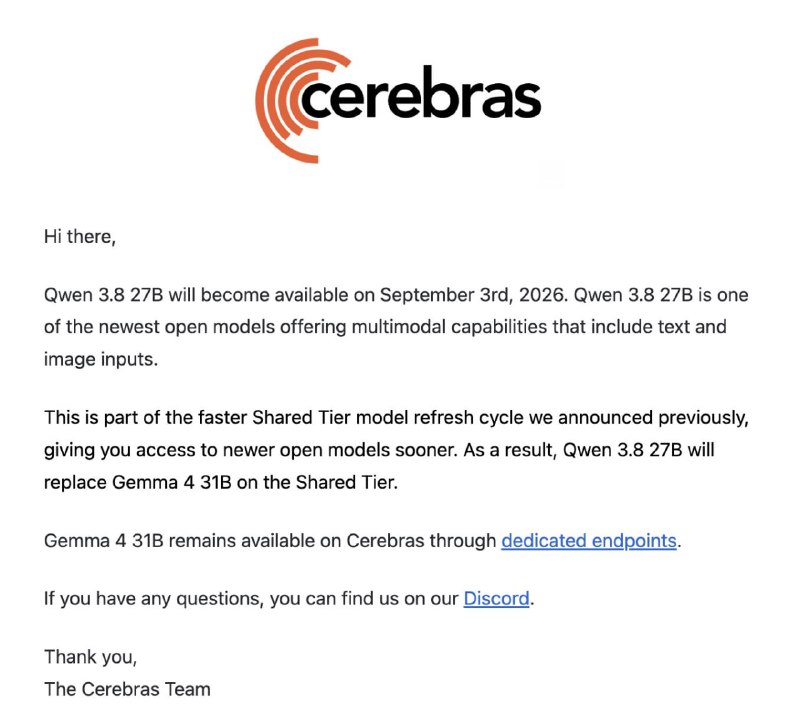
Cerebras ha anunciado el lanzamiento del alojamiento de Qwen 3.8 27B, que comenzará el 3 de septiembre, con una velocidad de procesamiento potencial de más de 2000 tokens por segundo.
Cerebras comenzará a alojar Qwen 3.8 27B a partir del 3 de septiembre.
En Cerebras, se espera que funcione a una velocidad de más de 2000 tokens por segundo. Esto es un aumento significativo en comparación con ChatGPT, que normalmente produce alrededor de 50–100 tokens por segundo, y el modo rápido de Codex, que es de aproximadamente 150–200 tokens.
Por lo tanto, Qwen en Cerebras podría potencialmente funcionar aproximadamente 10 veces más rápido que el modo rápido de Codex.
Por qué es importante
AnálisisEsto es importante ya que la velocidad de procesamiento de tokens puede afectar en gran medida la eficiencia de los modelos de IA en aplicaciones del mundo real. El lanzamiento de Qwen en Cerebras abre nuevas posibilidades para un procesamiento de datos más rápido.
Debatir en la comunidad
Comparte tus preguntas e ideas con desarrolladores
Relacionado en el ecosistema
Guías prácticas, terminología y skills de agentes
JSON — Datos estructurados para programas, APIs y agentes de IA
Guía práctica y completa sobre JSON: especificación de sintaxis, serialización con parse y stringify, consumo de APIs REST, validación con JSON Schema y salidas estructuradas para LLMs.
Formatos DOCX y XLSX: cuándo se necesita un documento final completo de la IA
Guía práctica y completa sobre la generación y procesamiento de documentos DOCX y libros XLSX con IA: comparativa con Markdown y CSV, ingeniería de prompts, fórmulas y automatización en código.
Binance publica una investigación sobre el robo de $6,300 millones
La investigación vincula el robo con una versión modificada de Homebrew, una entrevista falsa y el uso de una herramienta interna de IA de Binance.
Un usuario de Reddit explica por qué los límites semanales de Claude Code se consumen casi 4 veces más rápido
Un usuario de Reddit comparó el uso de tokens entre dos semanas y descubrió que ahora cada 1% del límite semanal de Claude Code genera muchos menos tokens de salida; señaló subagentes, tiempo de razonamiento y actualizaciones de interfaz como causas probables.