Cerebras héberge Qwen 3.8 27B dès le 3 septembre
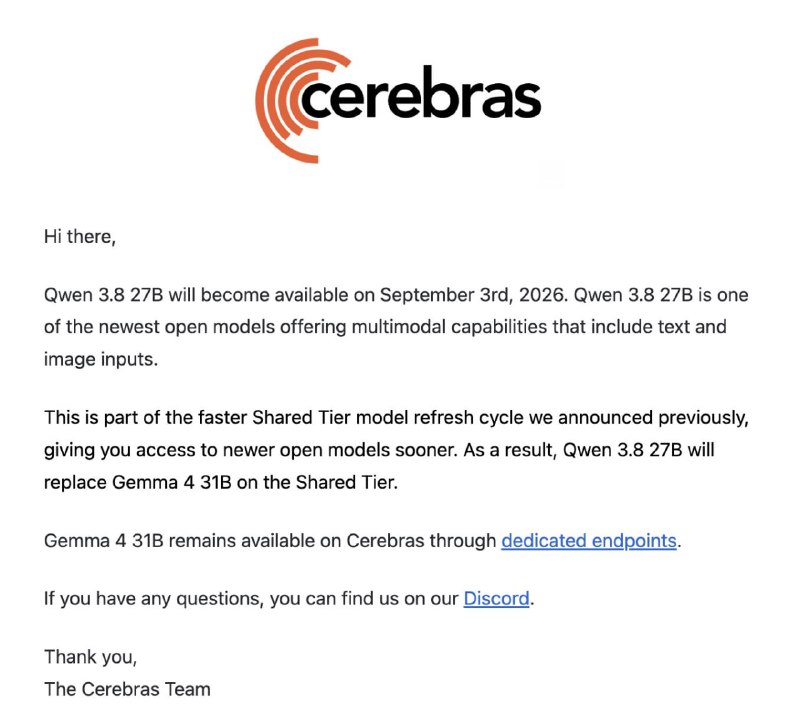
Cerebras annonce l'hébergement du modèle Qwen 3.8 27B à partir du 3 septembre, promettant une vitesse de traitement dépassant les 2000 tokens par seconde.
Cerebras débutera l'hébergement de Qwen 3.8 27B le 3 septembre.
Sur la plateforme Cerebras, le modèle devrait fonctionner à une vitesse supérieure à 2000 tokens par seconde. Il s'agit d'une augmentation significative par rapport à ChatGPT, qui génère généralement entre 50 et 100 tokens par seconde, et au mode rapide de Codex, situé autour de 150 à 200 tokens.
Ainsi, Qwen sur Cerebras pourrait potentiellement fonctionner environ dix fois plus vite que le mode rapide de Codex.
Pourquoi c'est important
AnalyseLa vitesse de traitement des tokens est un facteur critique pour l'efficacité des modèles d'IA dans les applications réelles. Le lancement de Qwen sur Cerebras ouvre la voie à un traitement des données beaucoup plus rapide.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs
Lié dans l'écosystème
Guides pratiques, terminologie clé et compétences d'agents
JSON — données structurées pour les applications, les API et les agents IA
Guide pratique complet du format JSON : règles de syntaxe, sérialisation via parse/stringify, intégration avec les API REST, schémas JSON et sortie structurée pour l'intelligence artificielle.
Formats DOCX et XLSX : quand un document final complet est nécessaire avec l'IA
Guide pratique complet sur la génération et le traitement de documents DOCX et de tableaux XLSX à l'aide de l'IA : comparaison avec Markdown et CSV, ingénierie des prompts, gestion des formules et automatisation dans le code.
Binance publie une enquête sur le vol de 6,3 milliards de dollars
L’enquête relie le vol à un Homebrew modifié, à un entretien d’embauche falsifié et à l’abus d’un outil d’IA interne de Binance.
Un utilisateur Reddit explique pourquoi les limites hebdomadaires de Claude Code se consomment presque 4 fois plus vite
Un utilisateur Reddit a comparé l’utilisation des tokens sur deux semaines et constaté que chaque 1 % de la limite hebdomadaire de Claude Code génère désormais beaucoup moins de tokens de sortie ; des sous-agents, la durée du raisonnement et les rafraîchissements de l’interface sont pointés comme causes possibles.