Cerebras vai alojar o Qwen 3.8 27B a partir de 3 de setembro
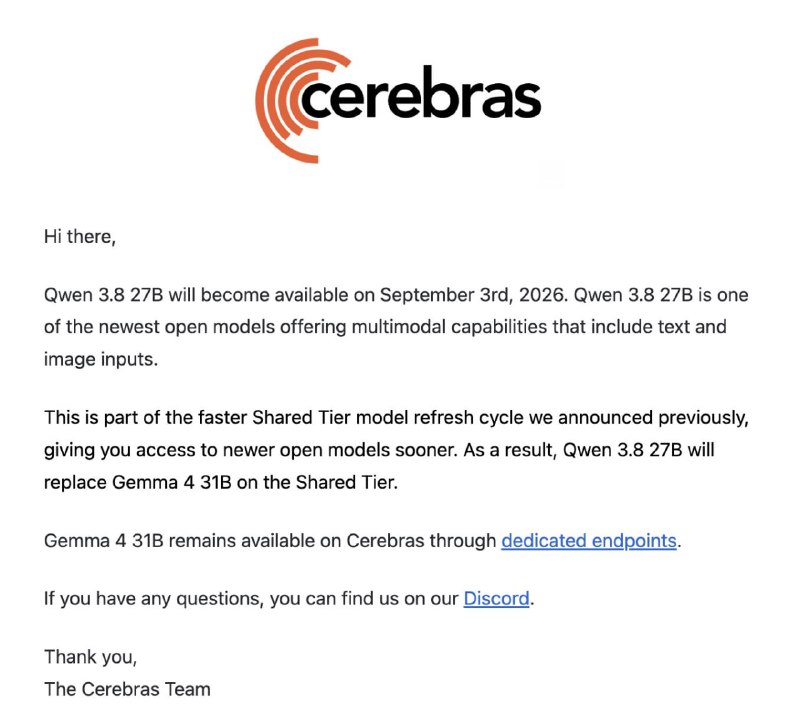
A Cerebras anuncia o lançamento do alojamento do modelo Qwen 3.8 27B, com início previsto para 3 de setembro e velocidades de processamento superiores a 2000 tokens por segundo.
A Cerebras iniciará o alojamento do modelo Qwen 3.8 27B no dia 3 de setembro.
Na infraestrutura da Cerebras, espera-se que o modelo opere a uma velocidade superior a 2000 tokens por segundo. Este é um aumento significativo em comparação com o ChatGPT, que tipicamente produz entre 50 a 100 tokens por segundo, e o modo rápido do Codex, que atinge cerca de 150 a 200 tokens por segundo.
Desta forma, o Qwen na plataforma Cerebras pode funcionar aproximadamente 10 vezes mais rápido do que o modo rápido do Codex.
Por que isso importa
AnáliseA velocidade de processamento de tokens impacta diretamente a eficiência dos modelos de IA em aplicações reais, sendo este avanço crucial para reduzir latências. O lançamento do Qwen na Cerebras abre novas possibilidades para o processamento de dados em alta velocidade.
Debater na comunidade
Compartilhe suas dúvidas e insights com desenvolvedores
Relacionado no ecossistema
Guias práticos, terminologia essencial e skills de agentes
JSON — dados estruturados para aplicações, APIs e agentes de IA
Guia prático completo sobre o formato JSON: regras de sintaxe, serialização via parse/stringify, integração com REST API, JSON Schema e saída estruturada para inteligência artificial.
Formatos DOCX e XLSX: quando é necessário um documento final completo gerado por IA
Guia prático completo para geração e processamento de documentos DOCX e planilhas XLSX com IA: comparação com Markdown e CSV, engenharia de prompts, trabalho com fórmulas e automação em código.
Binance publica investigação sobre roubo de US$ 6,3 bilhões
A investigação relaciona o roubo a um Homebrew modificado, a uma entrevista falsa e ao uso de uma ferramenta interna de IA da Binance.
Usuário do Reddit explica por que os limites semanais do Claude Code estão sendo consumidos quase 4 vezes mais rápido
Um usuário do Reddit comparou o uso de tokens em duas semanas e descobriu que cada 1% do limite semanal do Claude Code agora gera muito menos tokens de saída; subagentes, tempo de raciocínio e atualizações da interface são apontados como causas prováveis.