Cerebras uruchomi hosting Qwen 3.8 27B od 3 września
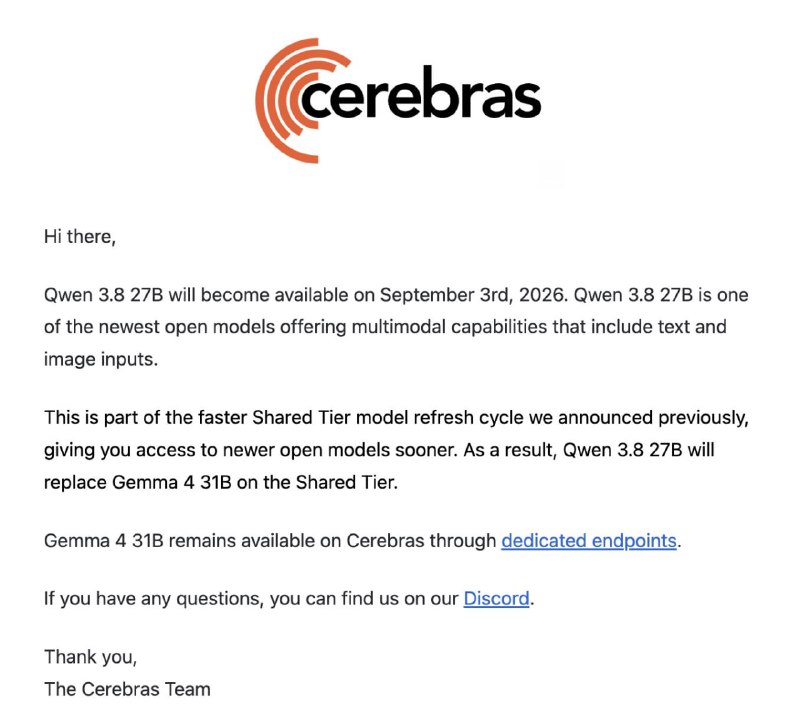
Cerebras ogłosił start hostingu modelu Qwen 3.8 27B, który ma osiągać prędkość przetwarzania powyżej 2000 tokenów na sekundę.
Cerebras rozpocznie świadczenie usług hostingu dla modelu Qwen 3.8 27B już 3 września.
Na infrastrukturze Cerebras oczekiwana jest prędkość działania przekraczająca 2000 tokenów na sekundę. Stanowi to znaczący wzrost w porównaniu z ChatGPT, który zazwyczaj generuje około 50–100 tokenów na sekundę, oraz trybem szybkim Codex, osiągającym poziom około 150–200 tokenów.
W praktyce oznacza to, że Qwen działający na platformie Cerebras może być nawet dziesięciokrotnie szybszy niż tryb szybki Codex.
Dlaczego to ważne
AnalizaPrędkość przetwarzania tokenów ma kluczowe znaczenie dla efektywności modeli AI w zastosowaniach rzeczywistych. Uruchomienie Qwen na Cerebras otwiera nowe możliwości w zakresie błyskawicznego przetwarzania danych.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami
Powiązane w ekosystemie
Praktyczne poradniki, kluczowa terminologia i skille agentów
JSON — dane ustrukturyzowane dla aplikacji, API i agentów AI
Kompletny praktyczny przewodnik po formacie JSON: zasady składniowe, serializacja za pomocą parse/stringify, praca z REST API, JSON Schema oraz strukturalne wyjście dla sztucznej inteligencji.
Formaty DOCX i XLSX: kiedy potrzebny jest pełnoprawny dokument końcowy od AI
Kompletny praktyczny przewodnik po generowaniu i przetwarzaniu dokumentów DOCX oraz arkuszy XLSX za pomocą AI: porównanie z Markdown i CSV, inżynieria promptów, praca z formułami oraz automatyzacja w kodzie.
Binance publikuje śledztwo w sprawie kradzieży 6,3 mld USD
Śledztwo wiąże kradzież ze zmodyfikowanym Homebrew, fałszywą rozmową kwalifikacyjną i wykorzystaniem wewnętrznego narzędzia AI Binance.
Użytkownik Reddita wyjaśnia, dlaczego tygodniowe limity Claude Code są wyczerpywane prawie cztery razy szybciej
Użytkownik Reddita porównał zużycie tokenów w dwóch tygodniach i stwierdził, że każdy 1% tygodniowego limitu Claude Code daje teraz znacznie mniej tokenów wyjściowych; wskazano subagentów, czas rozumowania oraz odświeżanie interfejsu jako prawdopodobne przyczyny.