Anthropic bada wewnętrzny świat myśli modelu Claude
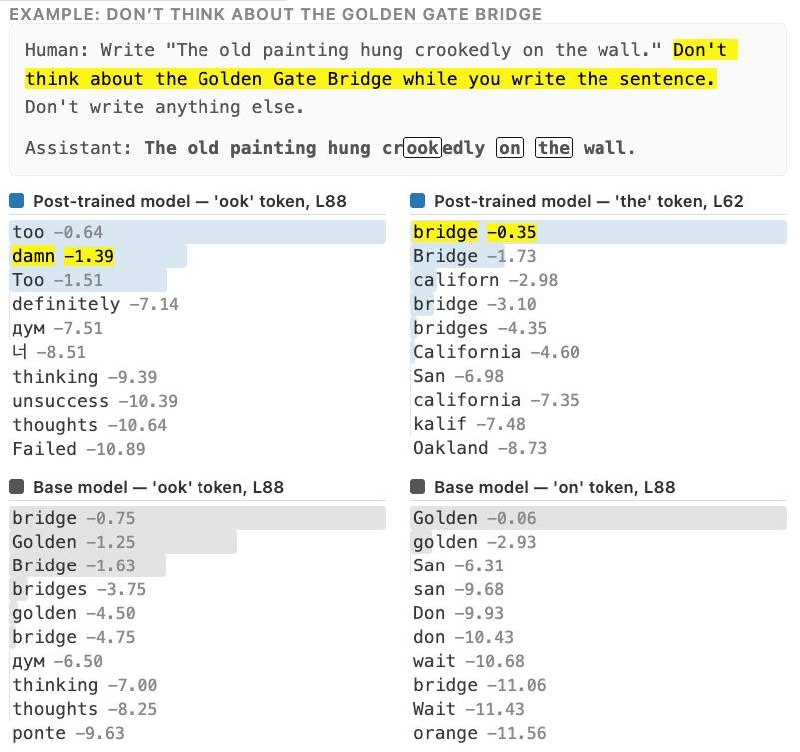
Firma Anthropic opublikowała przełomowe badanie ujawniające strukturę wewnętrznego przetwarzania modelu Claude. Odkrycie to podkreśla kluczową rolę interpretowalności w rozwoju sztucznej inteligencji.
Anthropic bada wewnętrzny świat myśli modelu Claude
Startup Anthropic zaprezentował jedną z najbardziej fascynujących prac dotyczących interpretowalności AI w ostatnich czasach. Badacze odkryli, że wewnątrz dużych modeli językowych (LLM) istnieje wydzielony, niewielki zestaw aktywacji neuronowych, który można poddawać analizie.
Przykład z badania
Humorystyczny przykład przytoczony w raporcie ilustruje ten mechanizm: gdy modelowi Claude polecono, by nie myślał o moście w San Francisco podczas odpowiadania na pytanie, jego wewnętrzna przestrzeń myślowa najpierw wygenerowała słowo „most”, a następnie „do diabła”.
Bardziej ludzkie niż się wydaje
To odkrycie sugeruje, że modele AI mogą dysponować złożonymi mechanizmami wewnętrznymi, które są bliższe ludzkiemu sposobowi myślenia, niż dotychczas zakładano.
Dlaczego to ważne
AnalizaBadanie to otwiera nowe horyzonty w zrozumieniu działania dużych modeli językowych. Interpretowalność jest fundamentem budowania przejrzystości i zaufania do technologii AI.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami
Powiązane w ekosystemie
Praktyczne poradniki, kluczowa terminologia i skille agentów
Claude staje się mądrzejszy
Claude staje się mądrzejszy, co wskazuje na możliwe ulepszenia możliwości modelu.
Anthropic wydaje więcej na wewnętrzne użycie Claude niż na wynagrodzenia
W prospekcie IPO Anthropic ujawniła, że wewnętrzne użycie Claude przewyższyło wynagrodzenia pracowników, jeśli liczyć je według stawek dla klientów.
Format Markdown: Kompletny przewodnik po pracy z AI i automatyzacją
Wyczerpujący, praktyczny przewodnik po składni Markdown w kontekście rozwoju AI: CommonMark, hierarchia nagłówków, tabele GFM, escapowanie znaków, prompty systemowe oraz pliki CLAUDE.md.
Sterowanie komputerem przez AI (Computer Use)
Technologia firmy Anthropic (wprowadzona w modelach Claude 3.5 Sonnet), która pozwala sieci neuronowej sterować systemem operacyjnym jak zwykły użytkownik: robić zrzuty ekranu, analizować współrzędne okien, poruszać kursorem myszy, klikać przyciski i wprowadzać tekst bez użycia dedykowanych API.