Ranking modeli AI: czy rzeczywiste płatne użycie przewyższa oficjalne benchmarki?
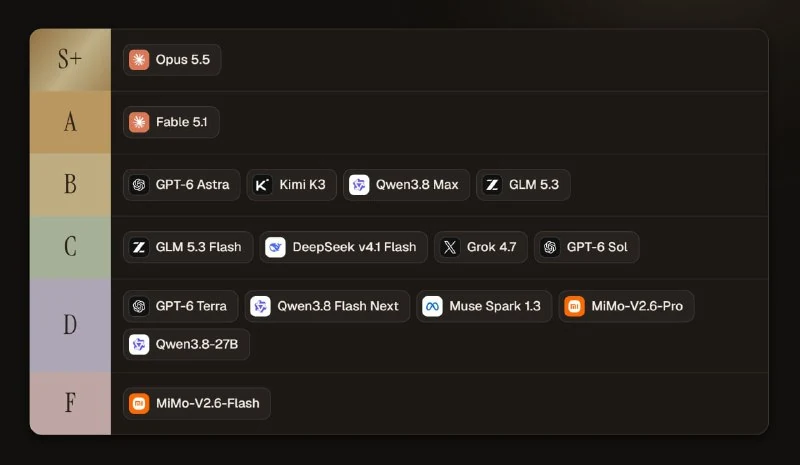
W sieci krąży nowy ranking modeli AI oparty na realnych, płatnych zastosowaniach, który może być trafniejszy niż standardowe testy. Metoda ta uwzględnia praktyczną użyteczność i koszty, a nie tylko syntetyczne metryki.
Ranking modeli AI: czy rzeczywiste płatne użycie przewyższa oficjalne benchmarki?
W internecie pojawił się nowy ranking modeli sztucznej inteligencji, który według wielu ekspertów może być bardziej precyzyjny niż większość oficjalnych benchmarków.
Kluczowa różnica polega na tym, że zestawienie to nie opiera się na zadaniach testowych, lecz na rzeczywistym użytkowaniu przy obciążeniach płatnych. Oznacza to, że pozycje w rankingu kształtują nie tylko syntetyczne wskaźniki, ale także praktyczna użyteczność, koszty oraz doświadczenia użytkowników.
Nasuwają się naturalne pytania: czy rzeczywiste, płatne wykorzystanie jest lepszym wyznacznikiem jakości modelu AI niż standardowe benchmarki?
Dlaczego to ważne
AnalizaRzeczywiste płatne użycie ujawnia mocne strony pomijane przez testy syntetyczne, jednak jego wyniki są trudne do powtórzenia i silnie zależne od specyficznych przepływów pracy.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami
Powiązane w ekosystemie
Praktyczne poradniki, kluczowa terminologia i skille agentów
Qwen4-Max już dostępna: 50% mniej tokenów i niższy koszt zadania
Qwen4-Max wprowadza architekturę MoE, kontekst 1 mln tokenów, wbudowaną obsługę obrazów oraz znaczną redukcję kosztów.
Claude Sonnet 4.6 vs GPT-5.5 vs Gemini 3.1 Pro: porównanie modeli na rok 2026
Co kilka tygodni pojawia się nowy model, a za każdym razem padają te same pytania: czy warto przejść? Co się zmieniło? Za co płacić?
Benchmarki dla agentów: GAIA i SWE-bench
Nowe pokolenie rygorystycznych, praktycznych benchmarków służących do oceny autonomii sztucznej inteligencji. GAIA testuje zadania multimodalne w otwartym internecie z wykorzystaniem plików i przeglądarki, natomiast SWE-bench sprawdza zdolność agentów do znajdowania i naprawiania rzeczywistych błędów w dużych repozytoriach GitHub.
Ocena agentów i benchmarking SWE-bench
Metodologia i infrastruktura systematycznego pomiaru niezawodności, dokładności i bezpieczeństwa agentów AI przy użyciu testów syntetycznych, SWE-bench oraz symulacji repozytoriów w trybie headless.