OpenAI : SWE-Bench Pro n'est plus adapté à l'évaluation des modèles
OpenAI a révélé que SWE-Bench Pro présente des défauts majeurs qui compromettent sa fiabilité, retirant ainsi sa recommandation d'utilisation et appelant la communauté à développer de nouveaux benchmarks.
OpenAI : SWE-Bench Pro n'est plus adapté à l'évaluation des modèles
Récemment, OpenAI a publié un article indiquant que l'un des benchmarks les plus populaires pour évaluer les capacités de codage des modèles – SWE-Bench Verified – n'était plus fonctionnel. L'entreprise y avait relevé de nombreux problèmes, affirmant que les résultats n'étaient pas fiables, et avait recommandé de passer à SWE-Bench Pro.
Cela remonte à fin février, il y a moins de cinq mois. Aujourd'hui, OpenAI annonce avoir mené une analyse similaire sur SWE-Bench Pro, révélant que ce dernier est également défaillant.
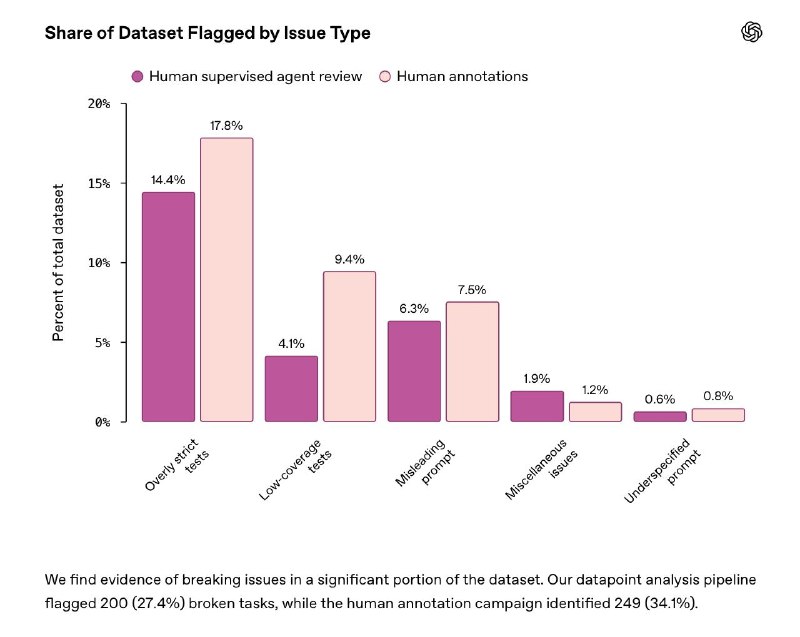
Dans le cas de SWE-Bench Verified, le problème principal résidait dans la reproduction des solutions « par cœur » par les modèles, due à des fuites de tâches dans les ensembles de données d'entraînement. Pour SWE-Bench Pro, la difficulté provient davantage de la conception des tâches elles-mêmes. Les issues et les Pull Requests (PR) provenant de dépôts open-source ont été initialement créées pour la collaboration humaine via de longues discussions et clarifications, plutôt que comme des tâches isolées et propres destinées à l'évaluation des modèles. Plus précisément, les problèmes suivants ont émergé :
- Des tests trop stricts imposant des détails d'implémentation spécifiques non mentionnés dans l'énoncé du problème, entraînant le rejet de nombreuses solutions fonctionnellement correctes.
- Des tests à faible couverture qui, inversement, ne vérifient pas adéquatement les fonctionnalités demandées, permettant à des solutions incomplètes de passer.
- Des conditions trompeuses qui orientent le modèle vers un comportement incorrect ou contredisent directement ce que les tests exigent.
OpenAI estime qu'environ 30 % des tâches de SWE-Bench Pro sont défectueuses (le pipeline de vérification automatisé a marqué 200 tâches comme corrompues, tandis que la campagne d'annotation manuelle en a identifié 249, soit 34,1 %). Lorsqu'un tiers des tâches d'un benchmark présentent de telles erreurs dans leurs conditions, il devient difficile de lui accorder sa confiance. C'est pourquoi OpenAI retire formellement sa précédente recommandation d'utiliser SWE-Bench Pro et « espère que la communauté développera de nouveaux benchmarks spécifiquement conçus pour tester les capacités des modèles ».
Pourquoi c'est important
AnalyseLes défauts des benchmarks peuvent fausser considérablement l'évaluation de l'efficacité des modèles d'IA. L'absence d'outils de test fiables risque d'entraver l'avancement technologique et la comparaison objective des performances.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs