OpenAI: SWE-Bench Pro ist für die Modellbewertung nicht mehr geeignet
OpenAI hat schwerwiegende Mängel im Benchmark SWE-Bench Pro identifiziert, der zuvor als Ersatz für das fehlerhafte SWE-Bench Verified empfohlen wurde. Das Unternehmen zieht seine Empfehlung zurück und fordert die Entwicklung neuer, robuster Teststandards.
OpenAI: SWE-Bench Pro ist für die Modellbewertung nicht mehr geeignet
Kürzlich veröffentlichte OpenAI eine Studie, in der festgestellt wurde, dass einer der beliebtesten Benchmarks zur Bewertung der Coding-Fähigkeiten von Modellen – SWE-Bench Verified – nicht mehr funktionsfähig ist. Das Team fand numerous Probleme, behauptete, dass die Ergebnisse nicht zuverlässig seien, und forderte alle auf, zu SWE-Bench Pro zu wechseln.
Dies geschah Ende Februar, vor weniger als fünf Monaten. Nun hat OpenAI angekündigt, dass sie einen ähnlichen Test für SWE-Bench Pro durchgeführt haben und es... ebenfalls defekt war.
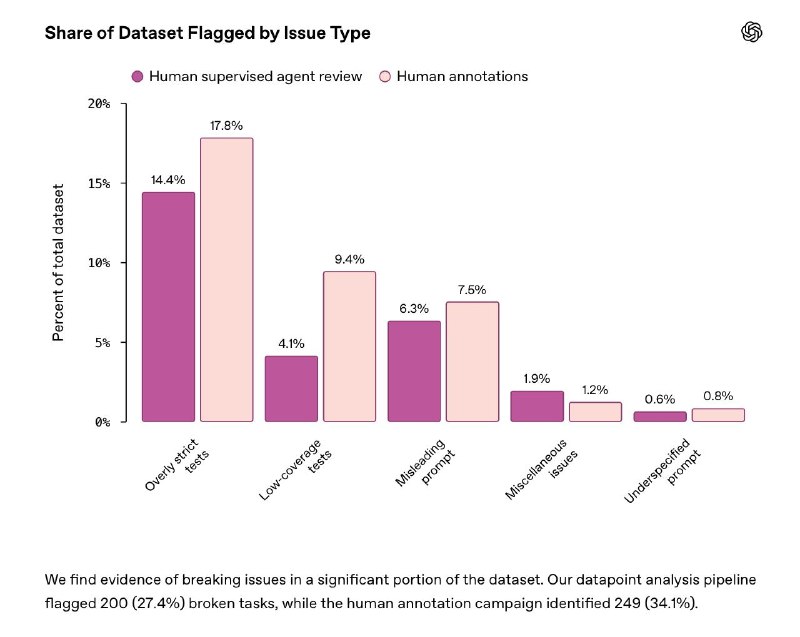
Im Fall von SWE-Bench Verified bestand das Hauptproblem darin, dass Modelle Lösungen "aus dem Gedächtnis" reproduzieren, da Aufgaben in den Trainingsdatensätzen durchgesickert sind. Hier liegt das Problem eher bei den Aufgaben selbst. Die Tatsache ist, dass Issues und Pull Requests aus Open-Source-Repositories ursprünglich für die menschliche Zusammenarbeit durch lange Diskussionen und Klärungen erstellt wurden, anstatt als isolierte, saubere Aufgaben für die Modellbewertung. Konkret traten folgende Probleme auf:
- Zu strenge Tests, die spezifische Implementierungsdetails vorschreiben, die nicht in der Problembeschreibung enthalten sind, wodurch viele funktional korrekte Lösungen abgelehnt werden.
- Tests mit geringer Abdeckung, die umgekehrt die angeforderte Funktionalität nicht angemessen prüfen, sodass unvollständige Lösungen bestehen können.
- Irreführende Bedingungen, die das Modell zu falschem Verhalten leiten oder direkt widersprüchlich zu dem sind, was die Tests verlangen.
OpenAI schätzt, dass etwa 30 % der SWE-Bench-Pro-Aufgaben fehlerhaft sind (die automatisierte Prüfpipeline markierte 200 Aufgaben als beschädigt, während die manuelle Annotationskampagne 249 Aufgaben, also 34,1 %, identifizierte). Wenn ein Drittel der Aufgaben des Benchmarks solche Fehler in ihren Bedingungen aufweist, ist es schwierig, ihm zu vertrauen. Daher zieht OpenAI seine vorherige Empfehlung zur Nutzung von SWE-Bench Pro formell zurück und "hofft, dass die Community neue Benchmarks entwickelt, die speziell darauf ausgelegt sind, die Fähigkeiten von Modellen zu testen".
Warum das wichtig ist
AnalyseDie Unzuverlässigkeit gängiger Benchmarks gefährdet die valide Leistungsmessung von KI-Modellen im Software-Engineering. Ohne robuste Testinstrumente droht eine Verzerrung der Fortschrittsbewertung und eine Verlangsamung der technologischen Innovation.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern