OpenAI: SWE-Bench Pro ya no es adecuado para la evaluación de modelos
OpenAI ha anunciado que SWE-Bench Pro tiene problemas graves que socavan su efectividad. Están pidiendo el desarrollo de nuevos benchmarks para la prueba de modelos.
OpenAI: SWE-Bench Pro ya no es adecuado para la evaluación de modelos
Recientemente, OpenAI publicó un artículo afirmando que uno de los benchmarks más populares para evaluar las capacidades de los modelos en programación – SWE-Bench Verified – ya no funciona. Encontraron numerosos problemas con él, afirmando que los resultados no son confiables, y urgieron a todos a cambiar a SWE-Bench Pro.
Esto ocurrió a finales de febrero, hace menos de 5 meses. Y ahora OpenAI ha anunciado que realizaron una prueba similar para SWE-Bench Pro, y también resultó estar roto.
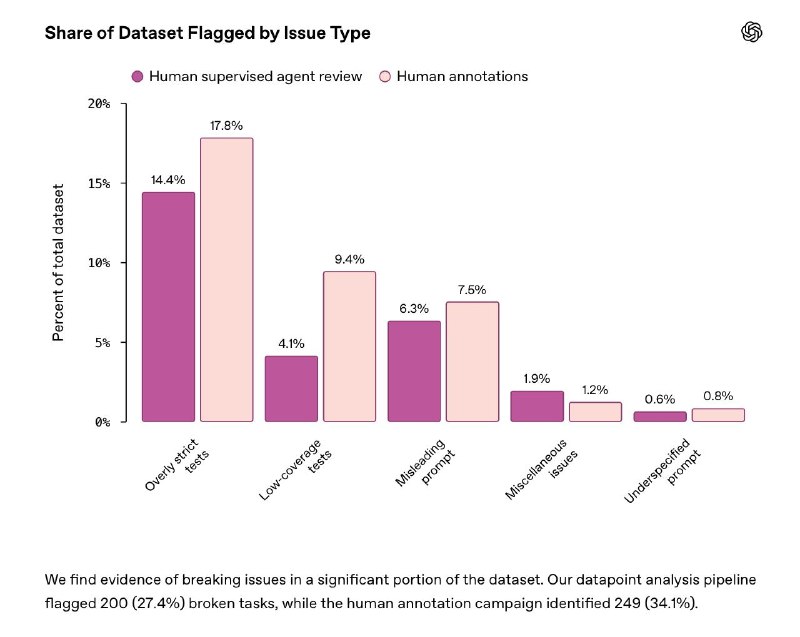
En el caso de SWE-Bench Verified, el principal problema era que los modelos reproducen soluciones "de memoria" debido a filtraciones de tareas en los conjuntos de datos de entrenamiento. Aquí, el problema radica más en las propias tareas. El hecho es que los issues y PR de los repositorios de código abierto se crearon originalmente para la colaboración humana a través de largas discusiones y aclaraciones, en lugar de como tareas aisladas y limpias para la evaluación de modelos. Específicamente, surgieron los siguientes problemas:
- Pruebas demasiado estrictas que imponen detalles específicos de implementación no indicados en la declaración del problema, lo que provoca que muchas soluciones funcionalmente correctas sean rechazadas.
- Pruebas con baja cobertura que, por el contrario, no verifican adecuadamente la funcionalidad solicitada, permitiendo que soluciones incompletas pasen.
- Condiciones engañosas que dirigen al modelo a un comportamiento incorrecto o contradicen directamente lo que requieren las pruebas.
OpenAI estima que aproximadamente el 30% de las tareas de SWE-Bench Pro están rotas (el pipeline de verificación automática marcó 200 tareas como corruptas, mientras que la campaña de anotación manual identificó 249 tareas, es decir, el 34.1%). Cuando un tercio de las tareas del benchmark tienen tales errores en sus condiciones, es difícil confiar en él, por lo que OpenAI retira formalmente su recomendación anterior de usar SWE-Bench Pro y "espera que la comunidad desarrolle nuevos benchmarks diseñados específicamente para probar las capacidades de los modelos".
Por qué es importante
AnálisisEsto es importante porque los problemas con los benchmarks pueden afectar significativamente la evaluación de la efectividad de los modelos de IA. La falta de herramientas de prueba confiables puede obstaculizar el avance tecnológico.
Debatir en la comunidad
Comparte tus preguntas e ideas con desarrolladores
Relacionado en el ecosistema
Guías prácticas, terminología y skills de agentes
Claude Sonnet 4.6 vs GPT-5.5 vs Gemini 3.1 Pro: comparación de modelos 2026
Cada pocas semanas sale un nuevo modelo y cada vez surgen las mismas preguntas: ¿debería cambiar? ¿Qué cambió por qué pagar?
Benchmarks para Agentes: GAIA y SWE-bench
Nueva generación de rigurosos benchmarks prácticos para evaluar la autonomía de la inteligencia artificial. GAIA prueba tareas multimodales en la web abierta con archivos y navegador, mientras que SWE-bench evalúa la capacidad de los agentes para encontrar y corregir errores reales en grandes repositorios de GitHub.
OpenAI GPT (Modelos Flagship de la Serie GPT)
La principal línea universal de grandes modelos de lenguaje de OpenAI (GPT-4, GPT-4o). Optimizada para análisis de texto complejo, programación, creatividad y trabajo intelectual diario.
OpenAI presenta GPT-6 Cyber, un modelo con récords para tareas de ciberseguridad
OpenAI reporta nuevos resultados de GPT-6 Cyber en ciberseguridad, incluyendo 48,5% en ExploitGym y el hallazgo de 81 vulnerabilidades desconocidas en Firefox, con acceso limitado por ahora.