OpenAI: SWE-Bench Pro não é mais adequado para avaliação de modelos
A OpenAI revelou falhas críticas no SWE-Bench Pro, retirando sua recomendação anterior e pedindo o desenvolvimento de novos benchmarks para testes de modelos.
OpenAI: SWE-Bench Pro não é mais adequado para avaliação de modelos
Recentemente, a OpenAI publicou um artigo afirmando que um dos benchmarks mais populares para avaliar as capacidades de codificação de modelos – o SWE-Bench Verified – não era mais funcional. Eles encontraram inúmeros problemas, alegando que os resultados não eram confiáveis, e instaram todos a migrarem para o SWE-Bench Pro.
Isso ocorreu no final de fevereiro, há menos de cinco meses. Agora, a OpenAI anunciou que realizou um teste semelhante para o SWE-Bench Pro, e ele... também se mostrou defeituoso.
No caso do SWE-Bench Verified, o principal problema era que os modelos reproduziam soluções "de memória" devido a vazamentos de tarefas nos conjuntos de dados de treinamento. Aqui, o problema reside mais nas próprias tarefas. A questão é que issues e PRs de repositórios open-source foram originalmente criados para colaboração humana através de longas discussões e esclarecimentos, em vez de serem tarefas isoladas e limpas para avaliação de modelos. Especificamente, os seguintes problemas surgiram:
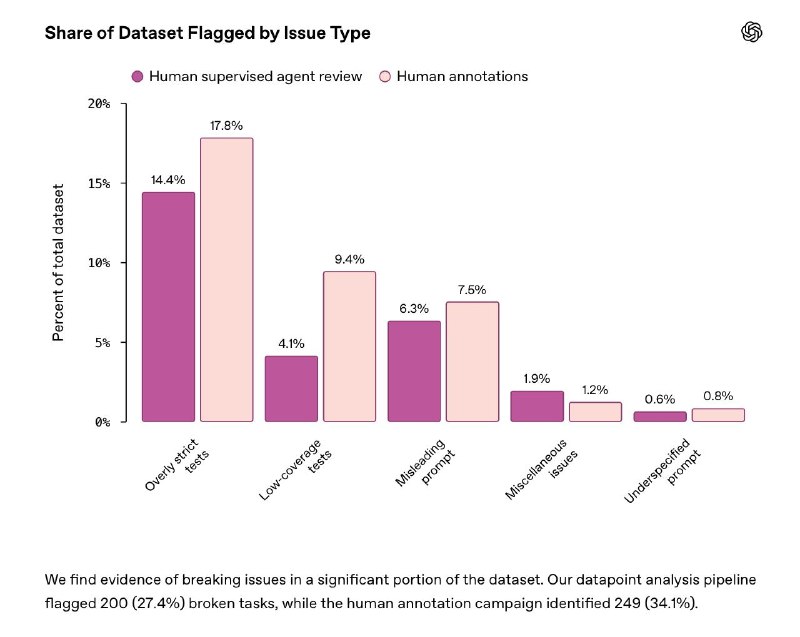
- Testes muito rigorosos que impõem detalhes específicos de implementação não declarados na descrição do problema, fazendo com que muitas soluções funcionalmente corretas sejam rejeitadas.
- Testes com baixa cobertura que, ao contrário, não verificam adequadamente a funcionalidade solicitada, permitindo que soluções incompletas passem.
- Condições enganosas que direcionam o modelo para comportamentos incorretos ou contradizem diretamente o que os testes exigem.
A OpenAI estima que aproximadamente 30% das tarefas do SWE-Bench Pro estão quebradas (o pipeline de verificação automática marcou 200 tarefas como corrompidas, enquanto a campanha de anotação manual identificou 249 tarefas, ou 34,1%). Quando um terço das tarefas do benchmark possui tais erros em suas condições, é difícil confiar nele, razão pela qual a OpenAI retira formalmente sua recomendação anterior de usar o SWE-Bench Pro e "espera que a comunidade desenvolva novos benchmarks especificamente projetados para testar as capacidades dos modelos".
Por que isso importa
AnáliseFalhas em benchmarks comprometem a avaliação precisa da eficácia dos modelos de IA, podendo atrasar o avanço tecnológico devido à falta de ferramentas de teste confiáveis.
Debater na comunidade
Compartilhe suas dúvidas e insights com desenvolvedores