OpenAI: SWE-Bench Pro більше не підходить для оцінки моделей
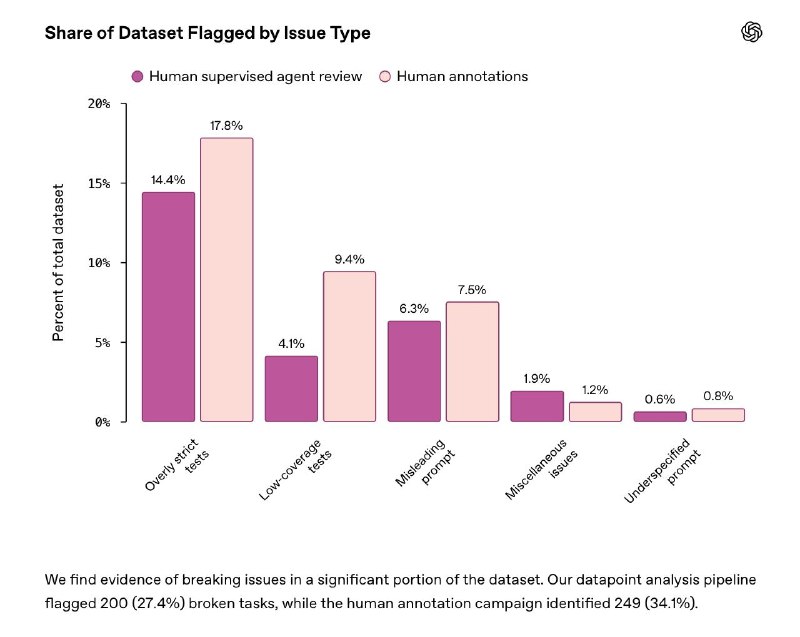
OpenAI оголосили, що SWE-Bench Pro має серйозні проблеми, які ставлять під сумнів його ефективність. Вони закликають до розробки нових бенчмарків для тестування моделей.
OpenAI: SWE-Bench Pro більше не підходить для оцінки моделей
Нещодавно OpenAI опублікували статтю, в якій заявили, що один з найпопулярніших бенчмарків для оцінки можливостей моделей у програмуванні – SWE-Bench Verified – більше не працює. Вони виявили в ньому безліч проблем, зазначивши, що результати на ньому мало що варті, і закликали всіх переходити на SWE-Bench Pro.
Це сталося в кінці лютого, менше ніж 5 місяців тому. І тепер OpenAI оголосили, що провели аналогічний тест для SWE-Bench Pro, і він... також виявився несправним.
У випадку з SWE-Bench Verified основна проблема полягала в тому, що моделі відтворюють рішення "по пам'яті" через витоки задач у навчальні датасети. Тут же проблема, скоріше, в самих задачах. Справа в тому, що issues і PR з опенсорсних репозиторіїв спочатку створювалися для людської співпраці через тривалі переписки та уточнення, а не як ізольовані, чисті задачі для оцінки моделей. Зокрема, виявилися такі проблеми:
- Занадто суворі тести, які нав'язують конкретні деталі реалізації, не вказані в умові задачі, через що безліч функціонально коректних рішень відбраковуються.
- Тести з низьким покриттям, які, навпаки, недостатньо перевіряють запитувану функціональність, через що неповні рішення все ще проходять.
- Вводять в оману умови, які спрямовують модель до неправильного поведінки або прямо суперечать тому, що вимагають тести.
OpenAI оцінює, що приблизно 30% задач SWE-Bench Pro несправні (автоматичний пайплайн перевірки позначив як зіпсовані 200 задач, а кампанія ручної анотації людьми – 249 задач, тобто 34,1%). Коли 1/3 задач бенчмарка – з такими помилками в умовах, довіряти йому складно, тому OpenAI формально відкликає свою попередню рекомендацію використовувати SWE-Bench Pro і "сподівається, що спільнота розробить нові бенчмарки, створені спеціально для тестування можливостей моделей".
Чому це важливо
АналітикаЦе важливо, оскільки проблеми з бенчмарками можуть суттєво вплинути на оцінку ефективності AI-моделей. Відсутність надійних інструментів для тестування може завадити розвитку технологій.
Обговорити новину у спільноті
Діліться своїм досвідом та думками з ШІ-розробниками
Пов'язані матеріали екосистеми
Практичні гайди, термінологія та агентські скіли
Claude Sonnet 4.6 vs GPT-5.5 vs Gemini 3.1 Pro: порівняння моделей 2026
Кожні кілька тижнів виходить нова модель, і щоразу ті самі запитання: чи варто переходити? що змінилося? за що платити?
Бенчмарки для агентів: GAIA та SWE-bench
Нове покоління суворих практичних бенчмарків для оцінки автономності штучного інтелекту. GAIA тестує мультимодальні завдання у відкритому вебі з файлами та браузером, а SWE-bench перевіряє здатність агентів знаходити та виправляти справжні баги у великих репозиторіях GitHub.
Agent Evals & SWE-bench Benchmarking
Методологія та інфраструктура систематичного вимірювання надійності, точності та безпеки ШІ-агентів за допомогою синтетичних тестів, SWE-bench та headless репозиторних симуляцій.
OpenAI представила ШІ-модель GPT-6 Cyber, яка знайшла 948 уразливостей у ядрі Linux
OpenAI анонсувала спеціалізовану ШІ-модель GPT-6 Cyber, яка виявила 948 уразливостей у ядрі Linux та понад 80 критичних уразливостей у Firefox.