OpenAI: SWE-Bench Pro nie nadaje się już do oceny modeli
OpenAI wycofało rekomendację dla benchmarku SWE-Bench Pro, wskazując na poważne błędy w zadaniach. Firma apeluje o stworzenie nowych, niezawodnych narzędzi do testowania zdolności kodowania AI.
OpenAI: SWE-Bench Pro nie nadaje się już do oceny modeli
Niedawno OpenAI opublikowało raport wskazujący, że jeden z najpopularniejszych benchmarków służących do oceny zdolności modeli w zakresie programowania – SWE-Bench Verified – przestał być funkcjonalny. Zidentyfikowano liczne problemy, które podważają wiarygodność wyników, a firma wezwała społeczność do przejścia na SWE-Bench Pro.
Wydarzyło się to pod koniec lutego, czyli niespełna pięć miesięcy temu. Teraz jednak OpenAI ogłosiło, że przeprowadziło analogiczne testy dla SWE-Bench Pro i... ten również okazał się uszkodzony.
W przypadku SWE-Bench Verified głównym problemem było to, że modele odtwarzały rozwiązania „z pamięci” ze względu na przecieki danych treningowych. Tutaj źródłem kłopotów są same zadania. Wady (issues) i pull requesty (PR) z repozytoriów open-source były pierwotnie tworzone z myślą o współpracy ludzi poprzez długie dyskusje i wyjaśnienia, a nie jako izolowane, czyste zadania do oceny modeli. Konkretnie wykryto następujące problemy:
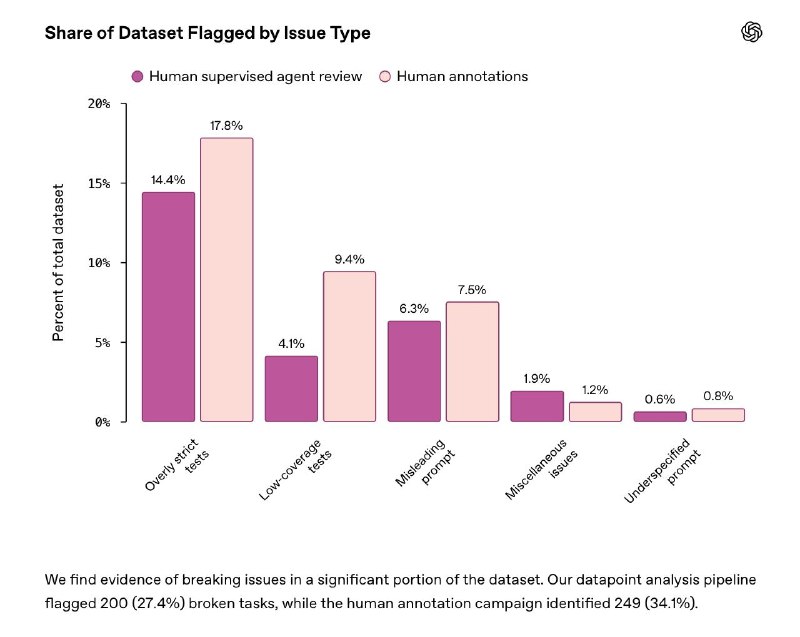
- Zbyt rygorystyczne testy narzucające specyficzne szczegóły implementacji niewskazane w treści problemu, co prowadzi do odrzucania wielu funkcjonalnie poprawnych rozwiązań.
- Testy o niskim pokryciu, które paradoksalnie nie sprawdzają adekwatnie wymaganej funkcjonalności, przepuszczając niekompletne rozwiązania.
- Mylące warunki, które kierują model do błędnych zachowań lub bezpośrednio contradictują wymaganiom testów.
OpenAI szacuje, że około 30% zadań w SWE-Bench Pro jest uszkodzonych (automatyczny pipeline oznaczył 200 zadań jako błędne, podczas gdy ręczna kampania adnotacyjna wykryła 249 zadań, czyli 34,1%). Gdy trzecia część benchmarku zawiera takie błędy w warunkach, trudno mu zaufać. Dlatego też OpenAI formalnie wycofuje swoją wcześniejszą rekomendację dotyczącą używania SWE-Bench Pro i „ma nadzieję, że społeczność opracuje nowe benchmarki specjalnie zaprojektowane do testowania możliwości modeli”.
Dlaczego to ważne
AnalizaBłędy w benchmarkach mogą znacząco wypaczać ocenę skuteczności modeli AI. Brak niezawodnych narzędzi testowych stanowi realną przeszkodę dla postępu technologicznego w branży.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami
Powiązane w ekosystemie
Praktyczne poradniki, kluczowa terminologia i skille agentów
Claude Sonnet 4.6 vs GPT-5.5 vs Gemini 3.1 Pro: porównanie modeli na rok 2026
Co kilka tygodni pojawia się nowy model, a za każdym razem padają te same pytania: czy warto przejść? Co się zmieniło? Za co płacić?
Benchmarki dla agentów: GAIA i SWE-bench
Nowe pokolenie rygorystycznych, praktycznych benchmarków służących do oceny autonomii sztucznej inteligencji. GAIA testuje zadania multimodalne w otwartym internecie z wykorzystaniem plików i przeglądarki, natomiast SWE-bench sprawdza zdolność agentów do znajdowania i naprawiania rzeczywistych błędów w dużych repozytoriach GitHub.
Ocena agentów i benchmarking SWE-bench
Metodologia i infrastruktura systematycznego pomiaru niezawodności, dokładności i bezpieczeństwa agentów AI przy użyciu testów syntetycznych, SWE-bench oraz symulacji repozytoriów w trybie headless.
OpenAI wprowadza GPT-6 Cyber: model AI znalazł 948 podatności w jądrze Linuxa
OpenAI zaprezentowało GPT-6 Cyber — wyspecjalizowany model AI, który wykrył 948 podatności w jądrze Linuxa oraz ponad 80 krytycznych podatności w Firefox.