Codage de Huffman : comment un doctorant du MIT a trouvé une méthode de compression encore utilisée 75 ans plus tard
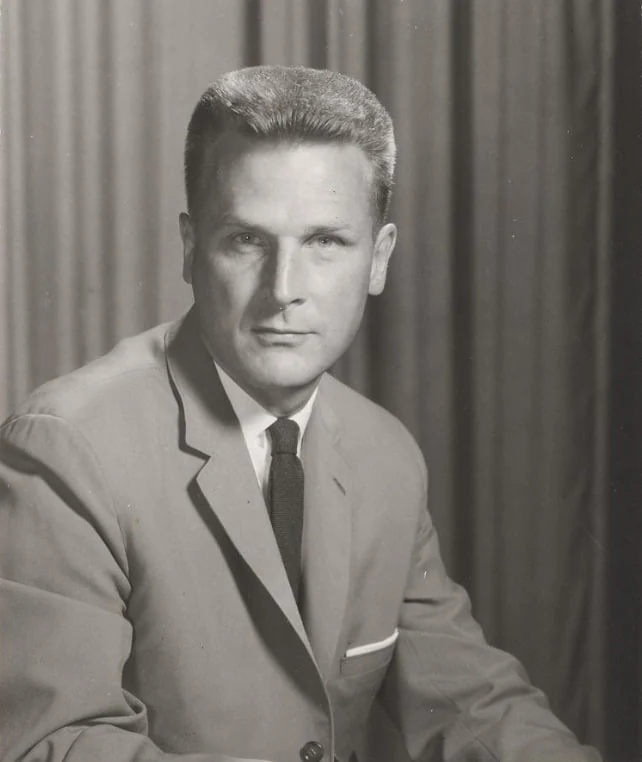
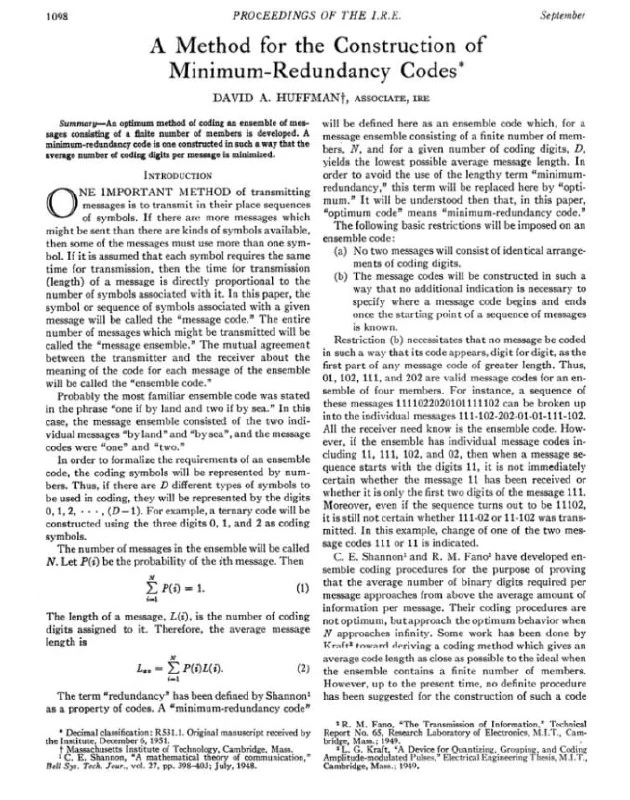
En 1951, David Huffman, doctorant au MIT, a conçu un code binaire efficace à longueur variable, toujours utilisé dans des formats comme ZIP, GZIP, JPEG et MP3.
En 1951, David Huffman, doctorant au Massachusetts Institute of Technology (MIT), a reçu un problème sur lequel même Claude Shannon et son professeur Robert Fano avaient travaillé sans succès. Il devait trouver la manière la plus efficace de coder des symboles avec des codes binaires de longueur variable, en tenant compte de la fréquence d’apparition de chaque symbole.
Pendant plusieurs mois, Huffman a essayé une approche après l’autre, mais la solution ne venait pas. Finalement, il était sur le point de jeter ses notes et de commencer à préparer son examen de fin d’études quand une idée lui est soudainement venue.
Au lieu de construire l’arbre de codage de haut en bas, il a décidé de procéder à l’inverse : partir du niveau inférieur et combiner de façon répétée les deux symboles les moins fréquents.
C’est ainsi qu’est né l’algorithme de Huffman, qui permet d’obtenir la longueur moyenne minimale des mots de code parmi tous les codes binaires préfixes pour des fréquences de symboles données.
Soixante-quinze ans plus tard, cet algorithme est encore utilisé dans des formats tels que ZIP, GZIP, JPEG et MP3.
Pourquoi c'est important
AnalyseLe codage de Huffman illustre parfaitement comment un changement de perspective peut résoudre un problème d’optimisation resté ouvert pendant des années. Son utilisation continue dans des formats très répandus montre que des idées algorithmiques simples et élégantes peuvent rester pertinentes pendant des décennies.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs
Lié dans l'écosystème
Guides pratiques, terminologie clé et compétences d'agents
Distillation de contexte et compression des jetons
Méthodes d'élimination automatique des mots superflus, du bruit syntaxique, des espaces de mise en forme et des messages obsolètes avant l'envoi du prompt au modèle, afin d'économiser le budget et d'accélérer l'inférence.
Déchargement et compression du KV-Cache
Méthodes matérielles et algorithmiques permettant de décharger temporairement le cache des clés et des valeurs (KV-Cache) de la mémoire vidéo GPU coûteuse vers la mémoire vive système (RAM) ou des SSD NVMe rapides.
Sous-agents et travail parallèle dans Claude Code : comment exécuter plusieurs tâches simultanément
Guide complet sur la parallélisation des tâches dans Claude Code : architecture des sous-agents, contexte partagé et isolé, modèles Fan-Out et Swarm, utilisation via CLI avec le flag -p et optimisation des tokens.
Claude Code Projects : comment une IA coordonne une équipe d'agents autonomes
Analyse approfondie de Claude Code Projects : architecture Coordinator et Threads, branches parallèles, mémoire partagée MEMORY.md et gestion des agents cloud.
OpenAI réduit les limites d’utilisation de ChatGPT Pro de 20x à 10x Plus
À partir du 29 octobre, OpenAI réduira les limites d’utilisation de ChatGPT Pro de 20 fois à 10 fois le volume de l’abonnement Plus, tout en maintenant le prix à 200 dollars par mois.
OpenAI lance GPT-6.1 Terra : performance proche de Sol, moitié moins chère et code plus rapide
GPT-6.1 Terra égale presque GPT-6.1 Sol sur les benchmarks tout en étant deux fois moins chère, avec une meilleure compréhension visuelle, l’usage de l’ordinateur et un texte plus naturel.