1. Qu'est-ce que les sous-agents dans Claude Code : du raisonnement séquentiel au parallèle
Une session de travail standard de Claude Code fonctionne en mode strictement séquentiel (boucle d'événements mono-thread). L'utilisateur envoie une requête, l'agent lit le contexte, effectue une recherche, édite un fichier, lance un linter ou des tests, et ne passe à la tâche suivante qu'après avoir terminé toute la chaîne. Lorsque le projet prend de l'ampleur et que le développeur est confronté à des dizaines de tâches mutuellement indépendantes, cette approche séquentielle entraîne des retards injustifiés et un encombrement rapide de la fenêtre de contexte.
Pour surmonter cette limitation, la concept de sous-agents a été intégré à l'architecture de Claude Code — des instances de modèle isolées et autonomes auxquelles sont délégués des fragments indépendants de la tâche globale.
Caractéristiques clés d'un sous-agent autonome
- Fenêtre de contexte propre et isolée : Le sous-agent n'est pas surchargé par l'historique long de la session principale, se concentrant exclusivement sur la tâche qui lui est confiée.
- Accès partagé au système de fichiers : Le sous-agent peut lire la structure des répertoires, les configurations du projet et les fichiers de code source avec les mêmes droits que le processus principal.
- Exécution asynchrone : Plusieurs sous-agents travaillent simultanément, réduisant le temps total d'exécution (wall-clock time) proportionnellement au nombre de flux parallèles.
- Agrégation automatique : Après avoir terminé son travail, le sous-agent génère un résumé structuré, le renvoie à la session parente et libère les ressources allouées.
Le modèle mental le plus simple pour comprendre les sous-agents est celui d'une gestion efficace du développement. Au lieu qu'un ingénieur Senior écrive lui-même, l'un après l'autre, la documentation pour cinq microservices, il crée 5 tâches distinctes et les confie à des exécutants parallèles, ne vérifiant que le résultat final de chacun.
2. Critères de parallélisation : quand diviser les tâches et quand travailler séquentiellement
La parallélisation n'est pas une panacée universelle. Son efficacité dépend directement du degré d'indépendance mutuelle des tâches. Tenter d'exécuter en parallèle des étapes interdépendantes provoque inévitablement des race conditions (conditions de course) et des collisions logiques.
| Scénario de développement | Mode optimal | Justification du choix |
|---|---|---|
| Génération de tests unitaires pour différentes utilitaires | Parallèle | Les modules ne dépendent pas les uns des autres, aucune dépendance partagée |
| Audit multi-vectoriel de sécurité, SEO et UI | Parallèle | Chaque direction analyse le système sous un angle différent, en lecture seule uniquement |
| Conception du schéma DB et génération des migrations | Séquentiel | Il est impossible d'écrire la migration avant la finalisation du modèle de base de données |
| Édition du même fichier de configuration | Séquentiel | Une écriture simultanée par plusieurs agents cause des conflits de fusion |
| Refactoring par lots de composants indépendants | Parallèle | Chaque composant se trouve dans un fichier séparé sans import croisé |
Quand la parallélisation est contre-indiquée
- Dépendance en cascade des résultats : Si l'étape B utilise les données de sortie de l'étape A. Par exemple : effectuer d'abord un audit du schéma de base de données, concevoir une nouvelle structure, puis seulement ensuite générer la migration Prisma.
- Points communs de modification de fichiers : Si l'Agent 1 et l'Agent 2 tentent simultanément d'apporter des modifications au même fichier
app.tsoupackage.json, l'une des écritures sera écrasée ou corrompue. - Tâches nécessitant un feedback humain itératif : Si les exigences ne sont pas définitivement fixées et que le développeur doit constamment ajuster la trajectoire via des questions de clarification, la tâche doit rester dans une session interactive unique.
Règle d'or de la parallélisation : avant de lancer un pool d'agents, donnez une réponse claire à la question : « Chaque agent peut-il accomplir sa tâche du début à la fin sans attendre les réponses intermédiaires des autres ? ». Si la réponse est « non » — travaillez exclusivement en séquentiel.
3. Architecture et mécanique de lancement des sous-agents via Task Tool
Au sein du moteur Claude Code, l'orchestration des sous-agents s'effectue via l'outil système Task tool. Lorsque le modèle dans la session principale comprend que la tâche se compose de composants isolés, il initie des processus enfants en arrière-plan.
L'utilisateur n'a généralement pas besoin d'appeler manuellement les instructions JSON système du Task tool — il suffit de formuler clairement la décomposition dans la requête ou de laisser Claude Code décomposer la tâche lui-même.
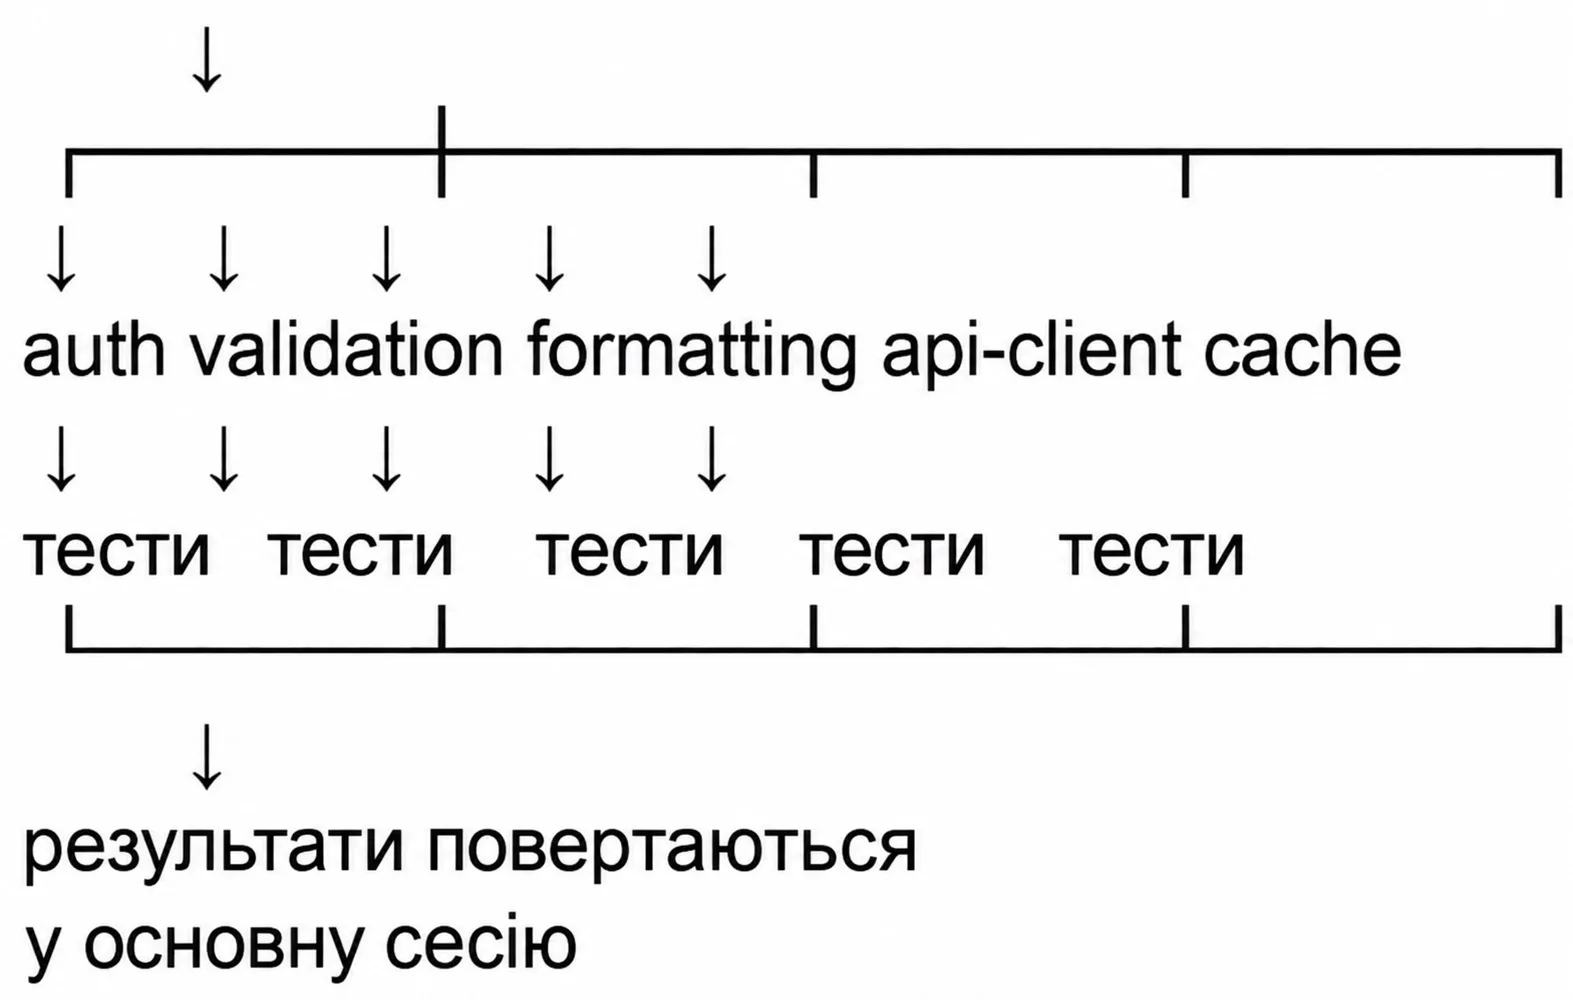 Architecture de lancement des sous-agents Claude Code et agrégation des résultats dans la session principale
Cycle de vie de l'exécution parallèle
- Dispatch de la tâche : La session principale reçoit un prompt complexe (par exemple, écrire des tests pour cinq utilitaires :
auth.ts,validation.ts,formatting.ts,api-client.ts,cache.ts). - Formation des contextes enfants : Des sous-agents distincts sont créés, chacun recevant une tâche personnalisée et le chemin vers le fichier cible.
- Travail autonome : Chaque agent lit en parallèle le code source de son module, explore les types de données, génère la suite de tests correspondante et vérifie son exécution.
- Merge inverse (Aggregation) : La session principale attend la fin de tous les flux, reçoit les statuts finaux d'exécution et présente au développeur un rapport consolidé.
4. Contexte partagé vs isolé : ce que voient les sous-agents
L'erreur la plus fréquente chez les développeurs débutants est de supposer que les sous-agents ont un lien télépathique entre eux ou qu'ils connaissent tout ce qui a été discuté à l'étape 50 du dialogue principal. En réalité, le modèle suit une politique stricte de séparation de la mémoire.
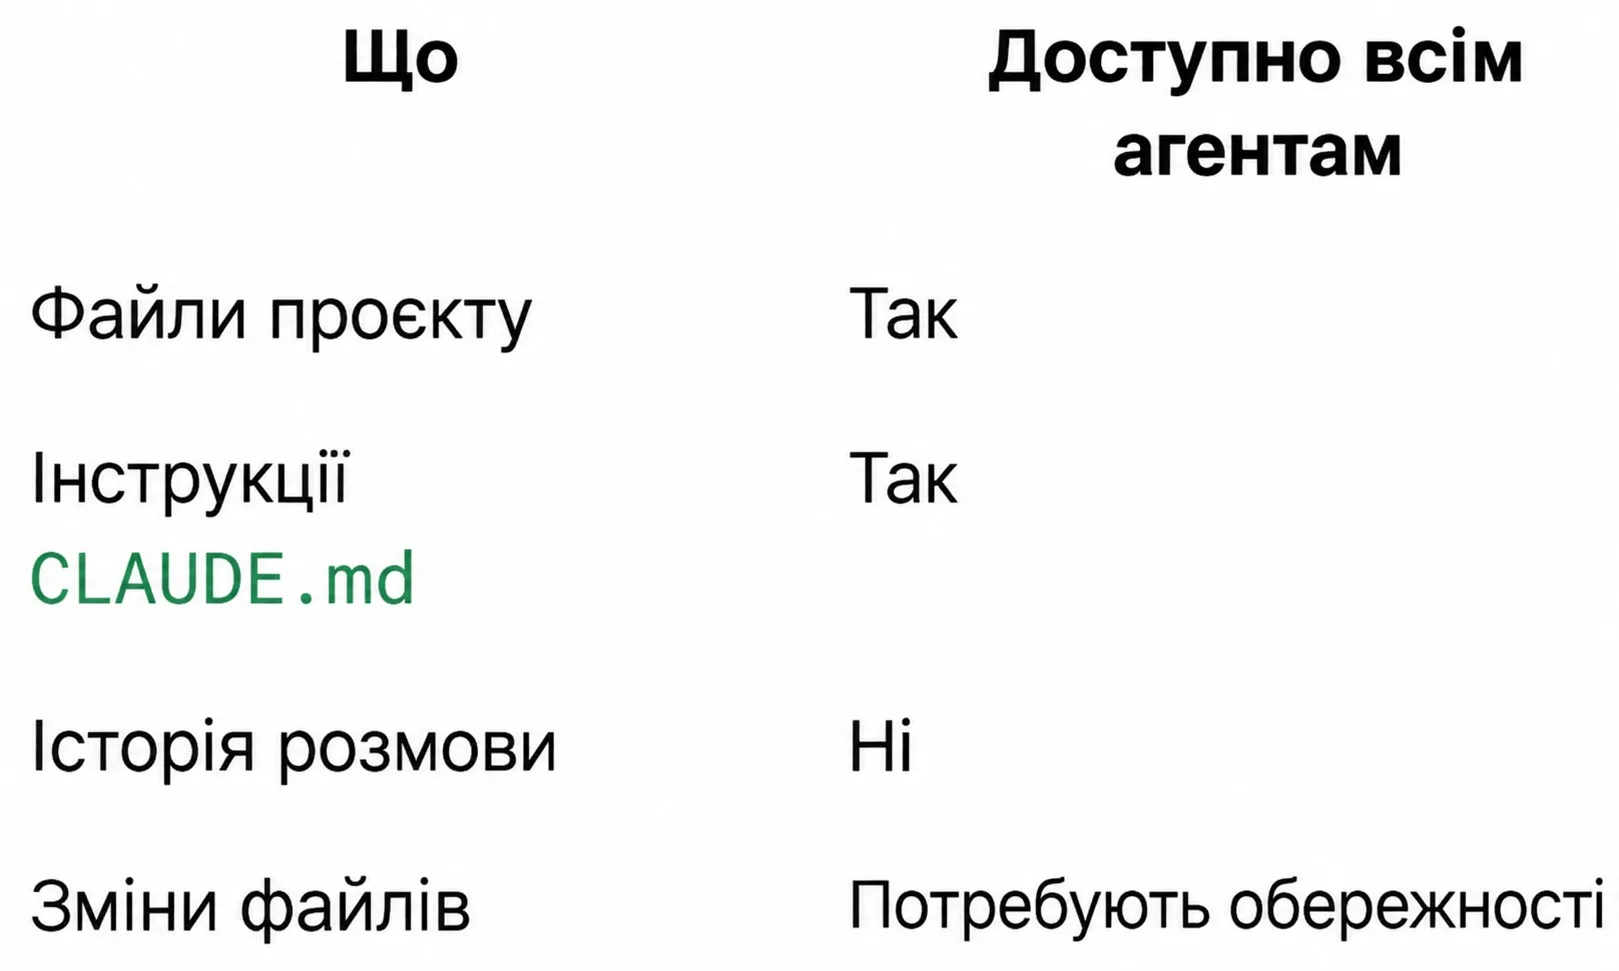 Contexte partagé et isolé des sous-agents : ce qui est accessible à tous les agents, et ce qui reste privé
| Ressource ou état du système | Partagé pour tous les agents ? | Description technique de l'accès |
|---|---|---|
| Fichiers du projet sur disque | Oui | Tous les agents ont accès en lecture et écriture au répertoire de travail |
| Règles CLAUDE.md | Oui | Chaque agent est automatiquement initialisé avec les règles du projet et de la stack |
| Historique du dialogue précédent | Non | Fenêtre isolée ; le sous-agent ne voit que son propre prompt direct |
| Modifications dans les fichiers ouverts | Prudence requise | Aucun mécanisme d'auto-verrouillage de fichier ; risque de collision lors de l'écriture |
Assurer la sécurité de l'écriture de fichiers (Write Ownership)
Pour éviter la corruption de la base de code lors d'un travail parallèle, respectez le principe du propriétaire unique du fichier :
Si plusieurs agents parallèles doivent enregistrer les modules créés dans un fichier index unique (src/index.ts ou src/routes.ts), ne leur déléguez pas cette tâche. Que les agents créent uniquement leurs fichiers isolés, et laissez la session parente effectuer l'enregistrement des imports dans le fichier index après le retour de tous les résultats.
5. Patterns de formulation de prompts pour lancer des agents parallèles
Bien que Claude Code dispose d'heuristiques pour détecter les tâches parallèles, une indication explicite de l'exécution simultanée élimine toute ambiguïté et optimise le temps de dispatch.
Exemples de formulation efficace de requêtes
6. Quatre schémas clés de travail parallèle : patterns prêts à l'emploi
L'expérience pratique de l'automatisation d'équipe avec Claude Code a permis de cristalliser quatre patterns architecturaux hautement efficaces d'orchestration parallèle.
Research Fan-Out (Recherche parallèle)
Utilisé lorsqu'il est nécessaire d'analyser simultanément plusieurs bibliothèques alternatives, technologies ou approches architecturales pour prendre une décision technique. Chaque agent étudie une stack spécifique selon des critères standardisés (avantages, inconvénients, compatibilité de licence, taille du bundle), après quoi la session principale synthétise une matrice comparative.
Audit Swarm (Audit multidisciplinaire)
L'un des patterns les plus économes en ressources en termes de gain de temps. Au lieu qu'un seul agent lise tout le dépôt quatre fois consécutives pour différents contrôles, quatre agents spécialisés sont lancés simultanément. Comme l'audit s'effectue exclusivement en mode lecture seule (read-only), le risque de conflit d'écriture de fichier est totalement absent.
Batch Processor (Refactoring par lots)
Appliqué lors de migrations à grande échelle où une transformation identique doit être effectuée sur un grand ensemble de fichiers indépendants :
- Conversion des anciens composants React class en hooks fonctionnels dans le répertoire
src/components/. - Réécriture des tests de Jest vers Vitest.
- Mise à jour des imports des anciennes utilitaires après leur extraction dans un monorepo.
Feature Sprint (Développement parallèle de features indépendantes)
Développement simultané de plusieurs modules UI ou endpoints API autonomes. Par exemple :
- Agent 1 implémente le toggle de thème sombre (
ThemeToggle.tsx+ contexte associé). - Agent 2 développe le formulaire de recherche globale (
SearchBar.tsx+ hook de recherche). - Agent 3 crée le menu déroulant de notifications (
NotificationsDropdown.tsx).
7. Lancement parallèle via CLI : mode Headless et flag -p
Outre la session interactive de Claude Code, il existe un outil puissant d'automatisation système : le lancement de Claude en mode headless (non interactif) à l'aide du flag -p (--print). Dans ce mode, l'agent reçoit le prompt comme argument de ligne de commande, exécute la tâche dans un processus terminal isolé et imprime le résultat.
Cela ouvre la possibilité d'utiliser les capacités natives d'exécution en arrière-plan des shells Unix-like (&) et l'utilitaire de synchronisation wait.
Avantages de la parallélisation CLI
- Supervision humaine nulle : Idéal pour les scripts CI/CD nocturnes, la préparation de suites de tests ou la pré-génération de documentation.
- Isolation OS réelle : Chaque processus
claudes'exécute dans un espace d'adressage distinct de l'OS. - Logging dans des fichiers : La sortie de chaque processus peut être facilement redirigée vers son propre fichier log :
claude -p "..." > logs/auth.log 2>&1 &.
Dans le terminal, l'opérateur & à la fin de la commande place le processus en arrière-plan, libérant le terminal pour lancer immédiatement la commande suivante. La commande intégrée wait bloque l'exécution du script jusqu'à ce que tous les PID en arrière-plan spécifiés aient terminé leur travail en retournant un code de sortie.
8. Économie de tokens, limites API et optimisation des coûts
Le travail parallèle économise radicalement le temps de l'ingénieur, mais exige un contrôle financier rigoureux. Chaque sous-agent crée sa propre fenêtre de contexte, donc le lancement parallèle de $N$ agents augmente la consommation de tokens d'environ $N$ fois.
Quatre règles de contrôle du budget de tokens
- Scope bien défini : Ne donnez pas à l'agent une directive générale telle que « Nettoie les tests du projet ». Formulez spécifiquement : « Écris 3 tests unitaires pour la fonction parseJwt dans src/utils/auth.ts ».
- Filtrage des fichiers : Si le projet contient de grands répertoires (par exemple, types générés ou mocks), assurez-vous qu'ils sont ajoutés à
.gitignoreou.claudeignoreafin que les sous-agents ne lisent pas des mégaoctets de texte inutile. - Utilisation de
-ppour les tâches triviales : Le lancement non interactif évite l'accumulation d'historique de conversation et sort le résultat sans déchets dialogiques superflus. - Regroupement des tâches trop petites : Créer un sous-agent séparé pour modifier une ligne de CSS est contre-productif — les frais généraux d'initialisation de session dépasseront le travail utile.
9. Workshop pratique : implémentation étape par étape, des tests à l'Audit Swarm
Consolidons les connaissances acquises lors d'un workshop pratique réel avec exécution étape par étape.
Étape 1. Sélection de modules isolés et préparation
Choisissez dans votre dépôt trois modules utilitaires qui n'ont pas d'imports cycliques ou mutuels :
src/utils/auth.tssrc/utils/validation.tssrc/utils/formatting.ts
Assurez-vous que les fichiers de test correspondants sont absents ou nécessitent une mise à jour.
Étape 2. Formation et lancement du prompt parallèle
Ouvrez une session interactive Claude Code dans le terminal du projet et saisissez une requête structurée :
Étape 3. Monitoring et vérification des résultats
Surveillez la sortie dans la console. Vous verrez Claude Code initier des tâches enfants, traiter indépendamment le code de chaque module et signaler la fin de chaque sous-processus.
Après achèvement, lancez une vérification dans votre terminal :
Les trois nouvelles suites de tests devraient passer la validation avec succès sans conflits dans la base de code.
Étape 4. Lancement de l'Audit Swarm pour évaluer la qualité
L'étape suivante consiste à tester le pattern analytique Audit Swarm. Envoyez la requête :
10. Aide-mémoire final et checklist de préparation à la parallélisation
Conservez cette checklist avant de lancer des pipelines parallèles massifs dans Claude Code.
Checklist de préparation au lancement parallèle
- Indépendance des tâches : Aucune tâche n'attend un artefact intermédiaire d'un autre agent parallèle.
- Isolation de l'écriture de fichiers : Chaque agent écrit ses données dans son propre nouveau fichier ou fichier isolé ; aucune lutte pour les fichiers de configuration partagés.
- Formulation précise des prompts : Fichiers d'entrée et de sortie clairs, stack technologique et critères de succès définis.
- Justification économique : Le gain de réduction du temps d'exécution dépasse le coût de duplication du contexte de base.
- Préparation de l'environnement : Tous les répertoires lourds externes sont exclus du contexte via
.claudeignore.
Matrice rapide de sélection d'outil
| Tâche | Approche recommandée | Commande / Méthode |
|---|---|---|
| Tests homogènes sur 5+ modules | Claude Code interactif ou CLI -p | claude -p "..." & |
| Audit multiprofessionnel du projet | Audit Swarm dans la session | Prompt interactif avec 4 agents |
| Comparaison de bibliothèques/technologies | Research Fan-Out | Synthèse dans un tableau récapitulatif |
| Refactoring profond du cœur du système | Session séquentielle (Single Session) | Session interactive classique avec humain |
11. Ressources suivantes recommandées
Pour approfondir vos connaissances sur l'écosystème Claude et l'automatisation des processus, nous vous recommandons de consulter nos nouveaux guides :
- 🚀 Claude Code Projects : comment une IA coordonne une équipe d'agents autonomes →
- 📊 Claude + Excel pour la logistique : 10 scénarios prêts à l'emploi d'audit tarifaire et de coûts →
- ⚡ Claude + Notion pour le business : automatisation CRM et tâches en 30 minutes →
- 🤖 Opérateur AI autonome Telegram 24/7 : architecture et 10 scénarios opérationnels →