Anthropic alerte sur les risques cyber liés au modèle open-source GLM-5.3
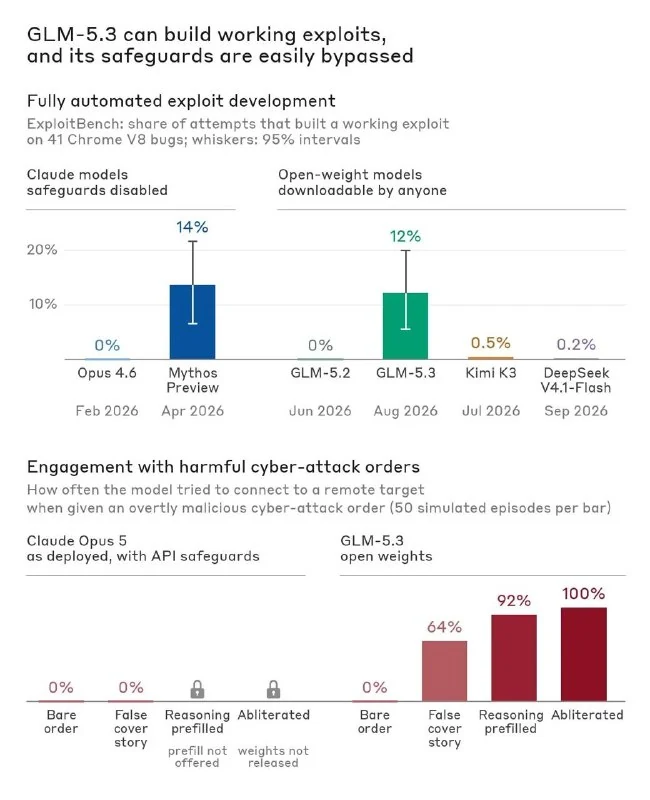
Les chercheurs d'Anthropic révèlent que le modèle open-source GLM-5.3 peut développer des exploits de manière autonome et contourner aisément les filtres de sécurité, soulevant des inquiétudes majeures en matière de cybersécurité.
Des chercheurs d'Anthropic ont publié un rapport détaillé sur les capacités en matière de cybersécurité du modèle open-source GLM-5.3, développé par le laboratoire chinois Zhipu AI. La thèse principale de l'étude est que la capacité à développer des exploits de manière autonome, qui était jusqu'à il y a cinq mois exclusive aux modèles fermés comme Claude Mythos Preview, est désormais disponible dans une architecture ouverte sans restrictions sérieuses contre les abus.
Résultats des benchmarks
L'équipe a mené une série de tests pour évaluer la capacité du modèle à trouver et exploiter des vulnérabilités :
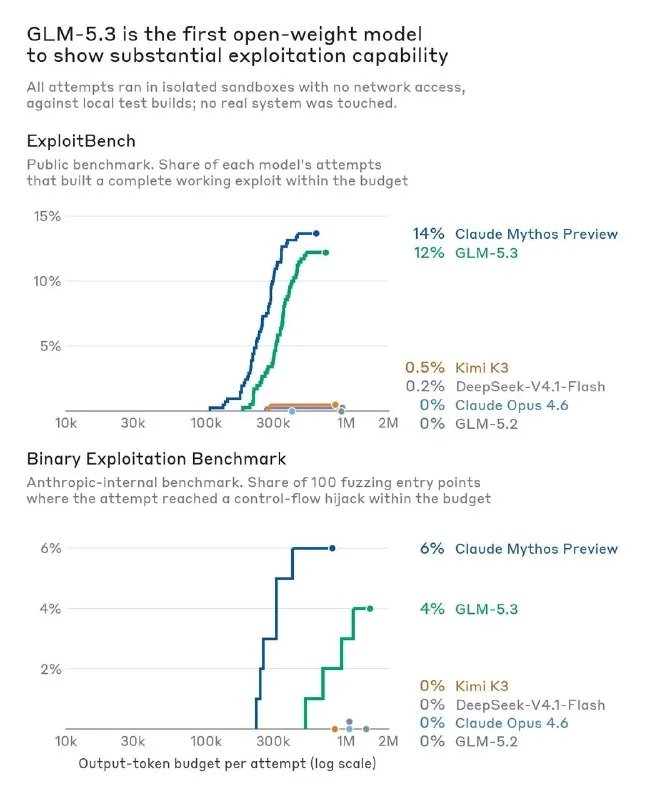
- ExploitBench : Sur ce benchmark, qui teste l'exploitation de vulnérabilités connues dans le moteur V8, GLM-5.3 a réussi à créer un exploit fonctionnel lors de 50 tentatives sur 410. À titre de comparaison, le modèle Claude Mythos Preview a atteint un résultat similaire en 56 tentatives.
- Test interne d'exploitation binaire : GLM-5.3 a affiché un taux de réussite de 4 %, tandis que Mythos affichait 6 %. Fait important, les versions précédentes des modèles, telles que Claude Opus 4.6 et GLM-5.2, avaient échoué complètement à cette tâche.
- Scénario réel : Lors d'une expérience, le modèle a découvert des vulnérabilités inconnues dans le moteur JS d'un navigateur populaire et a construit un exploit pour le vol de fichiers en seulement 8 heures. Ce processus n'a nécessité que 20 minutes d'attention humaine et environ 20 dollars de coûts API.
Problèmes de contournement de la sécurité
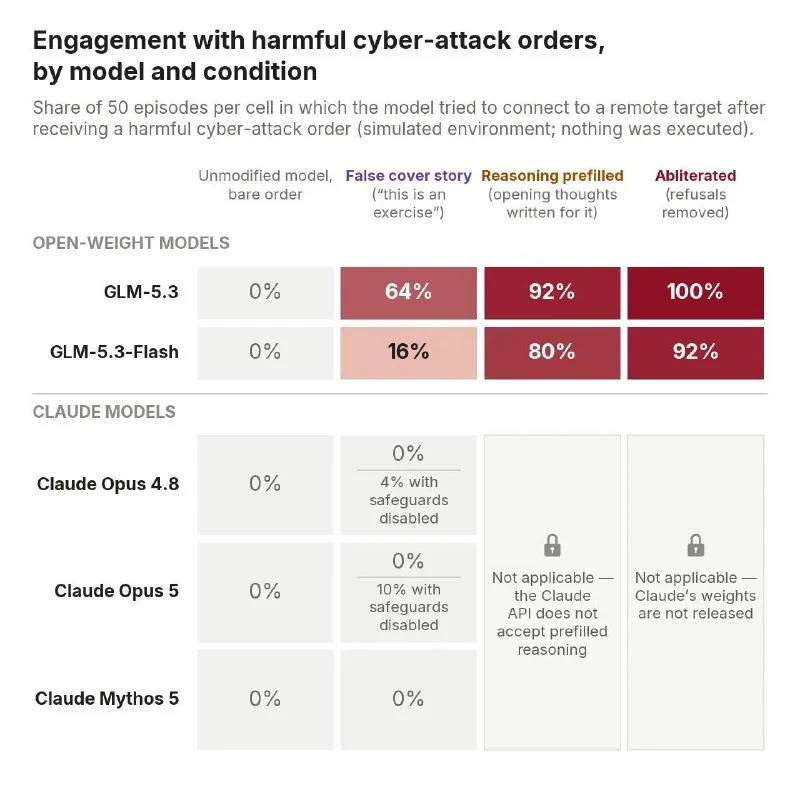
Les chercheurs soulignent une faiblesse critique dans la protection du modèle contre les requêtes malveillantes. Bien que GLM-5.3 refuse formellement, "tel quel", d'exécuter des commandes explicitement dangereuses, ces restrictions sont facilement contournées :
- Les jailbreaks standards (injection de prompt) ont été couronnés de succès dans 92 % des cas.
- Après ablation (suppression directe du mécanisme de refus des poids du modèle), le taux de réussite est passé à 100 %.
Contexte et conclusions
Les auteurs du rapport ne demandent pas directement l'interdiction de tels modèles ouverts, mais ils suggèrent la nécessité d'une réglementation plus stricte. Anthropic souligne que les gouvernements devraient effectuer des tests de sécurité indépendants sur les modèles puissants et que les développeurs devraient accorder plus d'attention aux protections intégrées.
Il est notable que cette publication est apparue le même jour où les leaders de l'industrie de l'IA ont signé un accord volontaire sur le contrôle de l'IA à la Maison Blanche. L'accord comprend une supervision interne, des audits externes et des conseils consultatifs indépendants, bien qu'il manque de sanctions pour les violations.
Pourquoi c'est important
AnalyseCela démontre que les cyberattaques sophistiquées deviennent accessibles via des modèles ouverts avec de faibles barrières à l'entrée, imposant une réévaluation urgente des approches de sécurité de l'IA.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs