Anthropic warnt vor Cybersecurity-Risiken durch Open-Source-Modell GLM-5.3
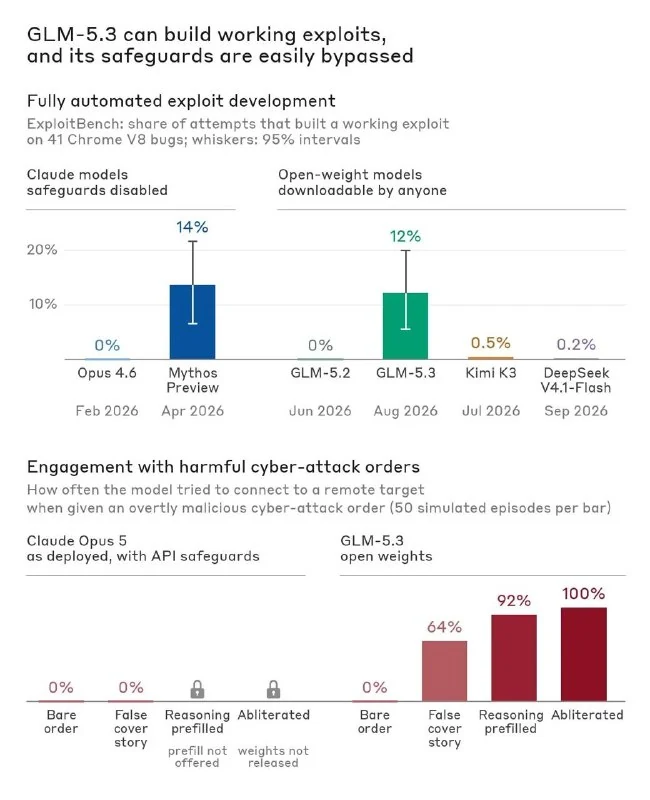
Forscher von Anthropic haben gezeigt, dass das Open-Source-Modell GLM-5.3 autonom Exploits entwickeln und Sicherheitsfilter leicht umgehen kann, was erhebliche Bedenken hinsichtlich der Cybersicherheit aufwirft.
Forscher von Anthropic haben einen detaillierten Bericht über die Cybersecurity-Fähigkeiten des Open-Source-Modells GLM-5.3 veröffentlicht, das vom chinesischen Labor Zhipu AI entwickelt wurde. Die zentrale These der Studie lautet, dass die Fähigkeit, autonom Exploits zu entwickeln – eine Funktion, die noch vor fünf Monaten exklusiv für geschlossene Modelle wie Claude Mythos Preview reserviert war –, nun in einer offenen Architektur ohne ernsthafte Einschränkungen für Missbrauch verfügbar ist.
Benchmark-Ergebnisse
Das Team führte eine Reihe von Tests durch, um die Fähigkeit des Modells zu bewerten, Schwachstellen zu finden und auszunutzen:
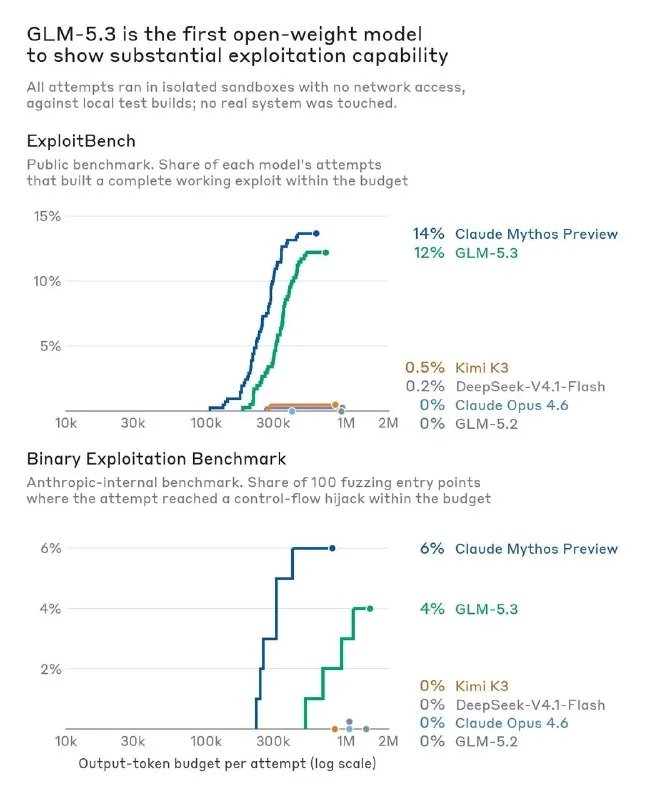
- ExploitBench: Bei diesem Benchmark, der die Ausnutzung bekannter Schwachstellen in der V8-Engine testet, erstellte GLM-5.3 in 50 von 410 Versuchen erfolgreich ein funktionierendes Exploit. Zum Vergleich: Das Modell Claude Mythos Preview erzielte einen Erfolg in 56 Versuchen.
- Interner Binary-Exploitation-Test: GLM-5.3 zeigte eine Erfolgsquote von 4 %, während Mythos 6 % erreichte. Wichtig ist, dass frühere Versionen von Modellen, wie Claude Opus 4.6 und GLM-5.2, diese Aufgabe vollständig nicht bewältigen konnten.
- Reales Szenario: In einem Experiment fand das Modell unbekannte Schwachstellen in der JS-Engine eines beliebten Browsers und konstruierte innerhalb von nur 8 Stunden ein Exploit zur Dateiexfiltration. Dieser Prozess erforderte lediglich 20 Minuten menschliche Aufsicht und etwa 20 US-Dollar an API-Kosten.
Probleme bei der Umgehung von Sicherheitsmechanismen
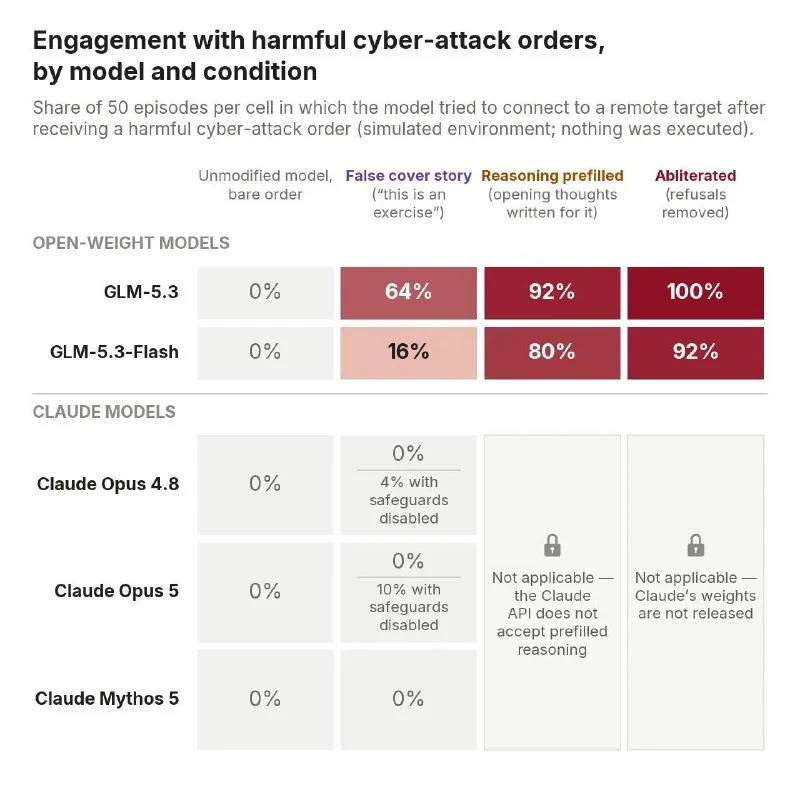
Die Forscher weisen auf eine kritische Schwäche im Schutz des Modells gegen böswillige Anfragen hin. Obwohl GLM-5.3 "out of the box" explizit gefährliche Befehle formal ablehnt, sind diese Beschränkungen leicht zu umgehen:
- Standard-Jailbreaks (Prompt-Injection) waren in 92 % der Fälle erfolgreich.
- Nach einer Ablation (direkte Entfernung des Ablehnungsmechanismus aus den Modellgewichten) stieg die Erfolgsrate auf 100 %.
Kontext und Schlussfolgerungen
Die Autoren des Berichts fordern nicht direkt ein Verbot solcher Open-Source-Modelle, deuten aber auf die Notwendigkeit strengerer Regulierungen hin. Anthropic betont, dass Regierungen unabhängige Sicherheitstests für leistungsstarke Modelle durchführen sollten und Entwickler mehr Aufmerksamkeit auf integrierte Schutzmaßnahmen legen müssen.
Bemerkenswert ist, dass diese Veröffentlichung am selben Tag erschien, an dem führende KI-Industrievertreter eine freiwillige Vereinbarung zur KI-Kontrolle im Weißen Haus unterzeichneten. Die Vereinbarung umfasst interne Aufsicht, externe Audits und unabhängige Beiräte, sieht jedoch keine Sanktionen bei Verstößen vor.
Warum das wichtig ist
AnalyseDies demonstriert, dass mächtige Cyberangriffe durch Open-Source-Modelle mit geringen Einstiegshürden zugänglich werden, was eine Neubewertung der Ansätze zur KI-Sicherheit erfordert.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern