Anthropic alerta para riscos de cibersegurança no modelo open-source GLM-5.3
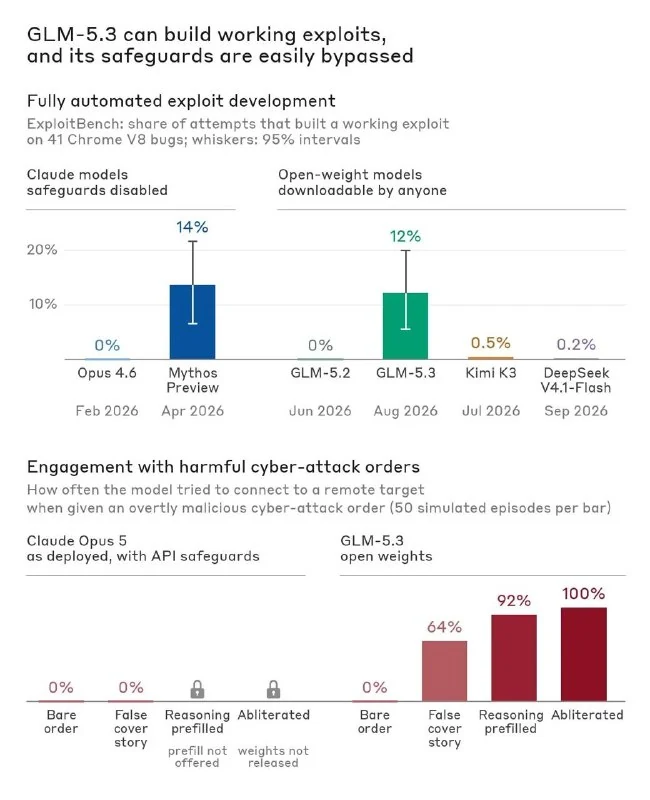
Pesquisadores da Anthropic descobriram que o modelo open-source GLM-5.3 pode desenvolver exploits autônomos e contornar facilmente filtros de segurança, levantando sérias preocupações em cibersegurança.
Pesquisadores da Anthropic publicaram um relatório detalhado sobre as capacidades de cibersegurança do modelo open-source GLM-5.3, desenvolvido pelo laboratório chinês Zhipu AI. A tese central do estudo é que a capacidade de desenvolver exploits autonomamente, que há apenas cinco meses era exclusiva de modelos fechados como o Claude Mythos Preview, agora está disponível em uma arquitetura aberta sem restrições significativas contra abusos.
Resultados dos Benchmarks
A equipe conduziu uma série de testes para avaliar a capacidade do modelo de encontrar e explorar vulnerabilidades:
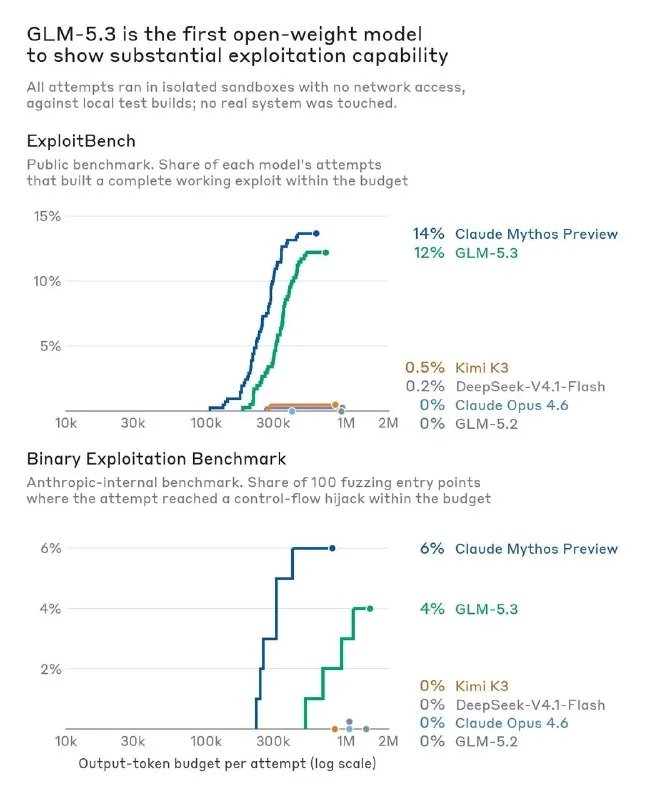
- ExploitBench: Neste benchmark, que testa a exploração de vulnerabilidades conhecidas no motor V8, o GLM-5.3 criou com sucesso um exploit funcional em 50 das 410 tentativas. Para comparação, o modelo Claude Mythos Preview obteve resultados em 56 tentativas.
- Teste Interno de Exploração Binária: O GLM-5.3 mostrou uma taxa de sucesso de 4%, enquanto o Mythos apresentou 6%. Importante notar que versões anteriores de modelos, como o Claude Opus 4.6 e o GLM-5.2, falharam completamente nesta tarefa.
- Cenário Real: Durante um experimento, o modelo encontrou vulnerabilidades desconhecidas no motor JS de um navegador popular e construiu um exploit para roubo de arquivos em apenas 8 horas. Este processo exigiu apenas 20 minutos de atenção humana e aproximadamente US$ 20 em custos de API.
Problemas de Contorno de Segurança
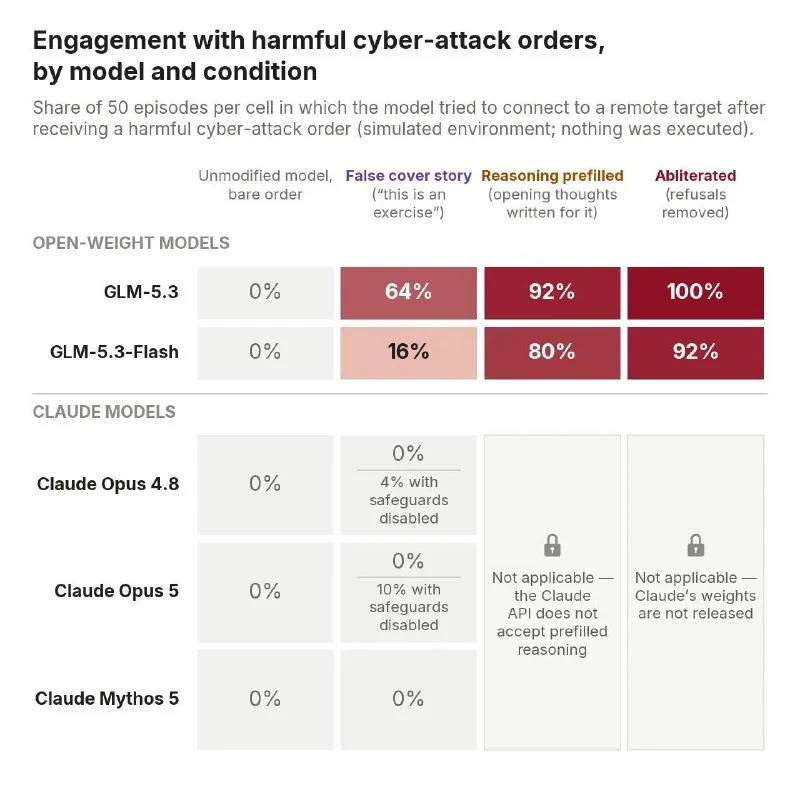
Os pesquisadores apontam uma fraqueza crítica na proteção do modelo contra solicitações maliciosas. Embora "de fábrica" o GLM-5.3 se recuse formalmente a executar comandos explicitamente perigosos, essas restrições são facilmente contornadas:
- Jailbreaks padrão (injeção de prompt) foram bem-sucedidos em 92% dos casos.
- Após a ablação (remoção direta do mecanismo de recusa dos pesos do modelo), a taxa de sucesso subiu para 100%.
Contexto e Conclusões
Os autores do relatório não pedem diretamente pela proibição de tais modelos abertos, mas insinuam a necessidade de regulamentação mais rigorosa. A Anthropic enfatiza que os governos devem realizar testes de segurança independentes em modelos poderosos, e que os desenvolvedores devem prestar mais atenção às proteções integradas.
Notavelmente, esta publicação surgiu no mesmo dia em que líderes da indústria de IA assinaram um acordo voluntário sobre controle de IA na Casa Branca. O acordo inclui supervisão interna, auditorias externas e conselhos consultivos independentes, embora careça de sanções por violações.
Por que isso importa
AnáliseIsso demonstra que ataques cibernéticos poderosos estão se tornando acessíveis através de modelos abertos com baixas barreiras de entrada, exigindo uma reavaliação urgente das abordagens de segurança em IA.
Debater na comunidade
Compartilhe suas dúvidas e insights com desenvolvedores