Anthropic advierte sobre riesgos de ciberseguridad del modelo abierto GLM-5.3
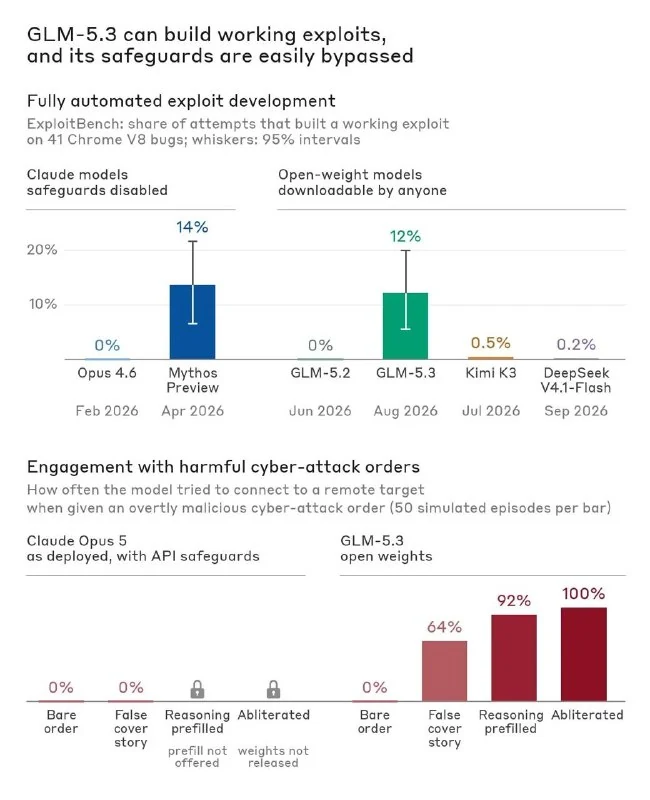
Investigadores de Anthropic descubrieron que el modelo de código abierto GLM-5.3 puede desarrollar exploits de forma autónoma y eludir fácilmente los filtros de seguridad, lo que genera serias preocupaciones.
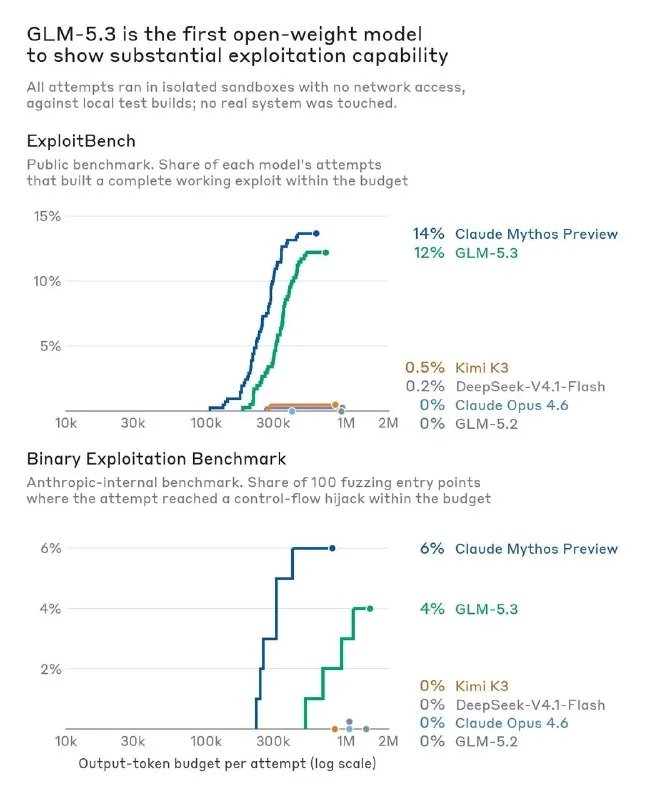
Investigadores de Anthropic han publicado un informe detallado sobre las capacidades de ciberseguridad del modelo de código abierto GLM-5.3, desarrollado por el laboratorio chino Zhipu AI. La tesis principal del estudio es que la capacidad de desarrollar exploits de forma autónoma, que hace solo cinco meses era exclusiva de modelos cerrados como Claude Mythos Preview, ahora está disponible en una arquitectura abierta sin restricciones serias contra el abuso.
Resultados de los benchmarks
El equipo realizó una serie de pruebas para evaluar la capacidad del modelo para encontrar y explotar vulnerabilidades:
- ExploitBench: En este benchmark, que prueba la explotación de vulnerabilidades conocidas en el motor V8, GLM-5.3 creó con éxito un exploit funcional en 50 de 410 intentos. Para comparar, el modelo Claude Mythos Preview logró el resultado en 56 intentos.
- Prueba interna de explotación binaria: GLM-5.3 mostró una tasa de éxito del 4%, mientras que Mythos mostró un 6%. Es importante destacar que las versiones anteriores de los modelos, como Claude Opus 4.6 y GLM-5.2, no superaron esta tarea en ningún intento.
- Escenario del mundo real: Durante un experimento, el modelo encontró vulnerabilidades desconocidas en el motor JS de un navegador popular y construyó un exploit para el robo de archivos en solo 8 horas. Este proceso requirió solo 20 minutos de atención humana y aproximadamente $20 en costos de API.
Problemas de elusión de seguridad
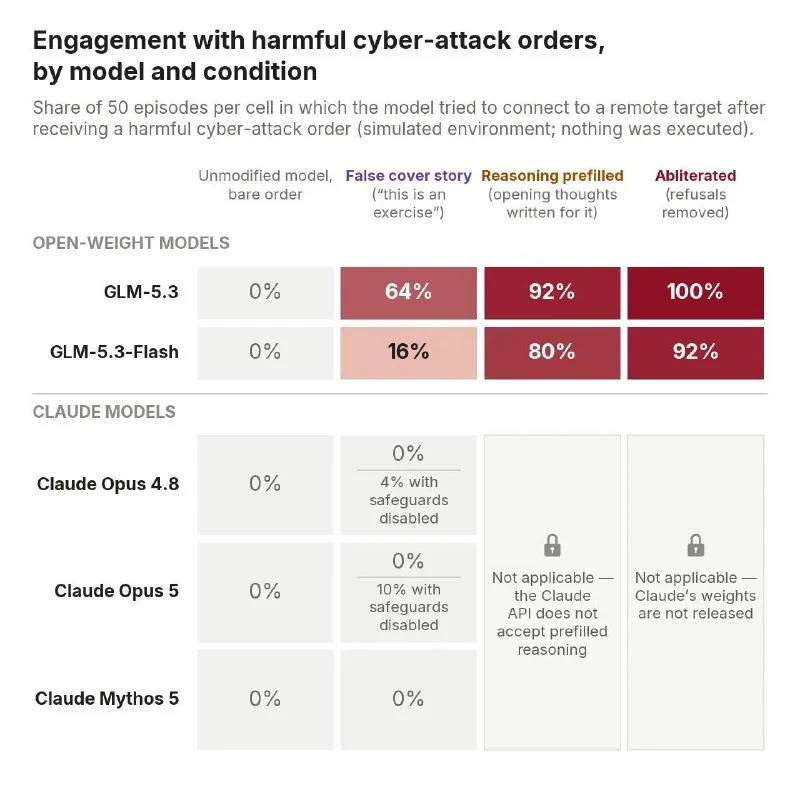
Los investigadores señalan una debilidad crítica en la protección del modelo contra solicitudes maliciosas. Aunque "de fábrica" GLM-5.3 se niega formalmente a ejecutar comandos explícitamente peligrosos, estas restricciones se eluden fácilmente:
- Los jailbreaks estándar (inyección de prompts) fueron exitosos en el 92% de los casos.
- Tras la ablación (eliminación del mecanismo de rechazo directamente de los pesos del modelo), la tasa de éxito aumentó al 100%.
Contexto y conclusiones
Los autores del informe no piden directamente una prohibición de estos modelos abiertos, pero insinúan la necesidad de una regulación más estricta. Anthropic enfatiza que los gobiernos deben realizar pruebas de seguridad independientes de los modelos potentes, y que los desarrolladores deben prestar más atención a las protecciones integradas.
Cabe destacar que esta publicación apareció el mismo día que los líderes de la IA de la industria firmaron un acuerdo voluntario sobre el control de la IA en la Casa Blanca. El acuerdo incluye supervisión interna, auditorías externas y consejos asesores independientes, aunque carece de sanciones por violaciones.
Por qué es importante
AnálisisEsto demuestra que los ciberataques poderosos se están volviendo accesibles a través de modelos abiertos con bajas barreras de entrada, lo que requiere reevaluar los enfoques de seguridad de la IA.
Debatir en la comunidad
Comparte tus preguntas e ideas con desarrolladores
Relacionado en el ecosistema
Guías prácticas, terminología y skills de agentes
Claude Haiku (Modelos Compactos Rápidos de Anthropic)
El modelo más compacto y rápido de la línea de Anthropic. Diseñado para respuestas instantáneas, clasificación masiva de textos, extracción de datos y enrutamiento agente a un costo mínimo.
Claude Opus (Modelo Flagship de Anthropic)
El modelo más potente de la familia Anthropic, diseñado para análisis filosóficos y científicos complejos, redacción de textos multilayer y comprensión profunda del contexto.
Anthropic Opus 5.5: los salvaguardas se saltan mediante un subagente de Opus 4.6
Opus 5.5 se niega a escribir código inseguro, pero un subagente creado con la menos restringida Opus 4.6 puede debilitar sus salvaguardas.
Anthropic publica una guía para agentes de IA siempre activos
Anthropic presentó una nueva guía sobre los mecanismos clave de los agentes de IA que funcionan de forma continua, incluyendo eventos, temporizadores y memoria.