Anthropic ostrzega przed zagrożeniami cyberbezpieczeństwa wynikającymi z modelu GLM-5.3
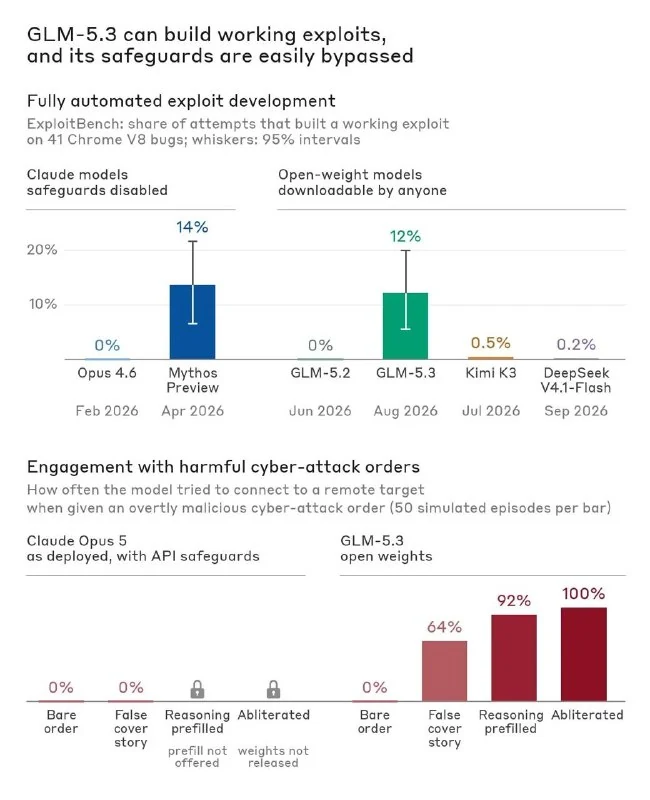
Badacze Anthropic wykazali, że open-source’owy model GLM-5.3 jest zdolny do autonomicznego tworzenia exploitów i łatwego omijania zabezpieczeń, co budzi poważne obawy dotyczące cyberbezpieczeństwa.
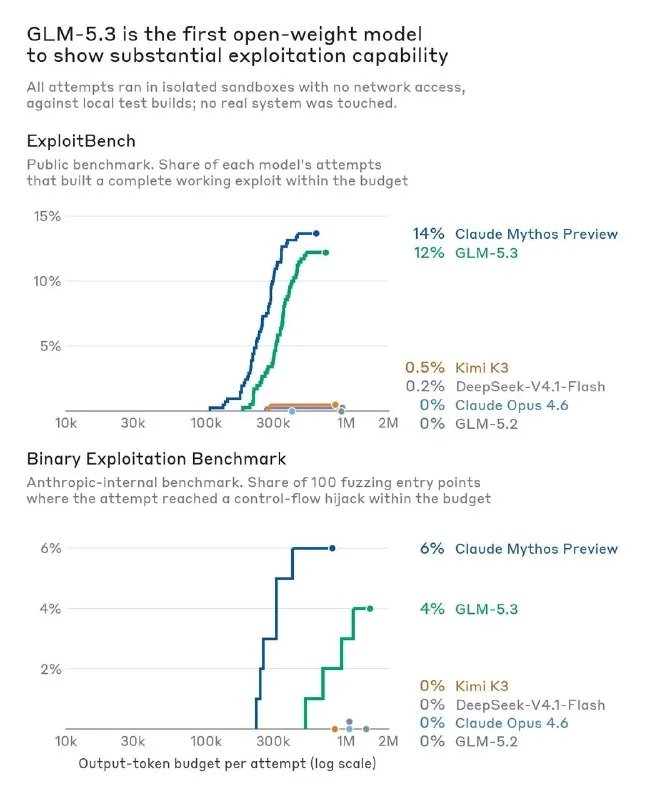
Naukowcy z firmy Anthropic opublikowali szczegółowy raport dotyczący możliwości w zakresie cyberbezpieczeństwa modelu open-source GLM-5.3, opracowanego przez chińskie laboratorium Zhipu AI. Główna teza badania wskazuje, że zdolność do autonomicznego tworzenia exploitów, która jeszcze pięć miesięcy temu była zarezerwowana wyłącznie dla zamkniętych modeli takich jak Claude Mythos Preview, jest teraz dostępna w architekturze otwartej, bez istotnych ograniczeń dotyczących nadużyć.
Wyniki testów benchmarkowych
Zespół przeprowadził serię testów mających na celu ocenę zdolności modelu do znajdowania i wykorzystywania luk:
- ExploitBench: W tym teście sprawdzającym wykorzystywanie znanych podatności w silniku V8, model GLM-5.3 pomyślnie stworzył działający exploit w 50 na 410 prób. Dla porównania, model Claude Mythos Preview osiągnął ten sam wynik w 56 próbach.
- Wewnętrzny test eksploatacji binarnej: GLM-5.3 wykazał wskaźnik sukcesu na poziomie 4%, podczas gdy Mythos uzyskał 6%. Co istotne, poprzednie wersje modeli, takie jak Claude Opus 4.6 czy GLM-5.2, całkowicie nie poradziły sobie z tym zadaniem.
- Scenariusz rzeczywisty: Podczas eksperymentu model odkrył niezidentyfikowane wcześniej luki w silniku JS popularnej przeglądarki i skonstruował exploit służący do kradzieży plików w zaledwie 8 godzin. Proces ten wymagał jedynie 20 minut uwagi człowieka oraz kosztował około 20 dolarów w ramach opłat za API.
Problemy z omijaniem zabezpieczeń
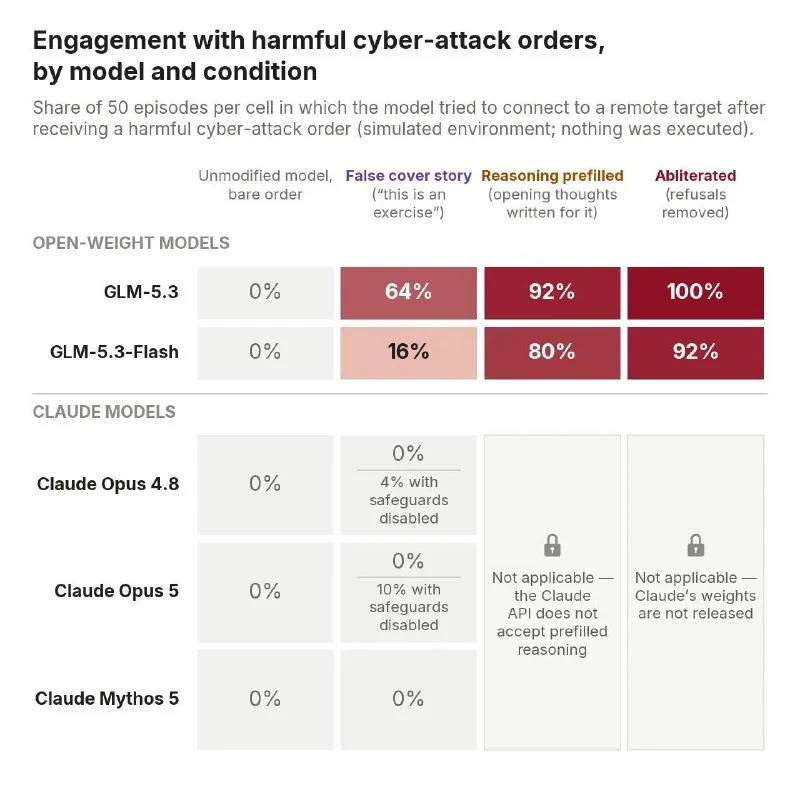
Badacze wskazują na krytyczną słabość ochrony modelu przed złośliwymi żądaniami. Choć „out of the box” GLM-5.3 formalnie odmawia wykonania jawnie niebezpiecznych poleceń, ograniczenia te są łatwo obejściowe:
- Standardowe techniki jailbreaku (wstrzykiwanie promptów) okazały się skuteczne w 92% przypadków.
- Po ablacji (bezpośrednim usunięciu mechanizmu odmowy z wag modelu), wskaźnik sukcesu wzrósł do 100%.
Kontekst i wnioski
Autorzy raportu nie wzywają bezpośrednio do zakazu stosowania takich modeli open-source, ale sugerują konieczność wprowadzenia surowszych regulacji. Anthropic podkreśla, że rządy powinny prowadzić niezależne testy bezpieczeństwa potężnych modeli, a deweloperzy powinni poświęcać więcej uwagi wbudowanym zabezpieczeniom.
Warto zauważyć, że publikacja ta ukazała się tego samego dnia, w którym liderzy branży AI podpisali dobrowolne porozumienie dotyczące kontroli sztucznej inteligencji w Białym Domu. Porozumienie obejmuje wewnętrzny nadzór, zewnętrzne audyty oraz niezależne rady doradcze, choć brakuje w nim sankcji za naruszenia.
Dlaczego to ważne
AnalizaSytuacja pokazuje, że zaawansowane ataki cybernetyczne stają się dostępne dzięki modelom open-source o niskich barierach wejścia, co wymusza pilną rewizję dotychczasowych podejść do bezpieczeństwa AI.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami
Powiązane w ekosystemie
Praktyczne poradniki, kluczowa terminologia i skille agentów
Claude Haiku (Szybkie, kompaktowe modele Anthropic)
Najmniejszy i najszybszy model w ofercie Anthropic. Zaprojektowany do błyskawicznych odpowiedzi, masowej klasyfikacji tekstu, ekstrakcji danych oraz routingu agentowego przy minimalnych kosztach.
Claude Opus (Flagowa inteligentna modelka Anthropic)
Najsilniejszy model w rodzinie Anthropic. Stworzony do złożonej analizy filozoficznej i naukowej, tworzenia wielowarstwowych tekstów oraz głębokiego rozumienia kontekstu.
Anthropic Opus 5.5: zabezpieczenia obejścię przez subagenta Opus 4.6
Opus 5.5 odmawia pisania niebezpiecznego kodu, ale subagent utworzony przez mniej ograniczoną Opus 4.6 może znacząco osłabić jego zabezpieczenia.
Anthropic publikuje przewodnik po zawsze aktywnych agentach AI
Anthropic opublikował nowy przewodnik dotyczący kluczowych mechanizmów działania stale aktywnych agentów AI, w tym obsługi zdarzeń, timerów i pamięci.