Sakana AI proponuje alternatywę inspirowaną mózgiem dla treningu sieci neuronowych
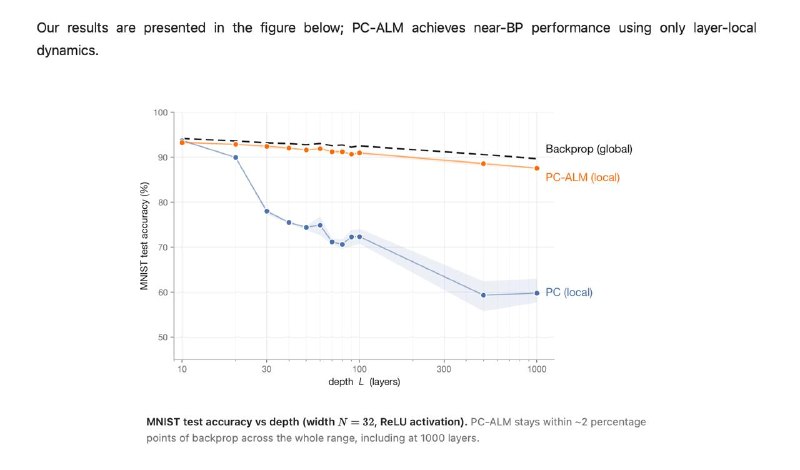
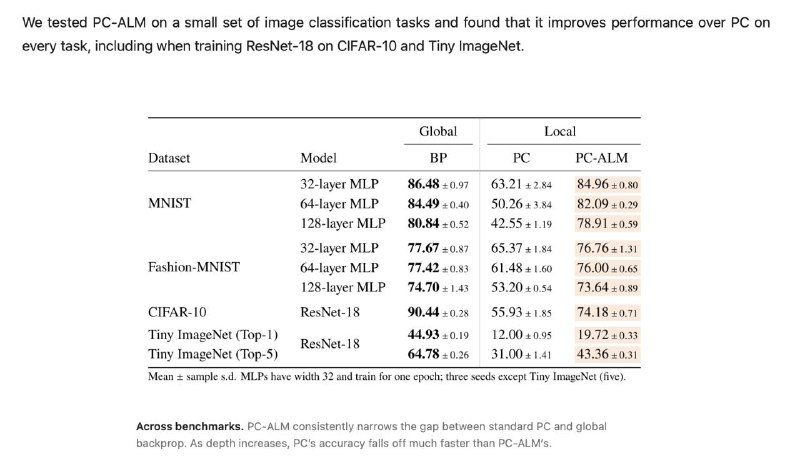
Sakana AI wprowadza metodę PC-ALM, łączącą kodowanie predykcyjne z mnożnikami Lagrange'a, umożliwiając lokalne trenowanie głębokich sieci i naśladowanie biologicznych procesów uczenia się.
Sakana AI proponuje alternatywę inspirowaną mózgiem dla treningu sieci neuronowych
Wszystkie współczesne sieci neuronowe, których używamy, są trenowane za pomocą wstecznej propagacji błędu (backpropagation). Ten algorytm, wynaleziony w latach 70. XX wieku, jest wciąż powszechnie stosowany.
Jednak wobec tej metody istnieje kilka krytyk. Główny problem tkwi w jej strukturze. Backprop działa ściśle w trzech sekwencyjnych fazach: najpierw sygnał przechodzi przez sieć do przodu, aby wygenerować wynik; następnie sygnał błędu podróżuje od wyjścia do wejścia; tylko wtedy aktualizowane są wagi. Z biologicznego punktu widzenia jest to bardzo nieprawdopodobne: nie istnieje mechanizm, który zmuszałby nasze neurony do czekania na sygnał błędu docierający z innego miejsca przez wszystkie inne neurony, zanim będą mogły się zaktualizować.
Sakana AI jest znana z czerpania inspiracji z neurobiologii. Firma proponuje spojrzenie na podejście zwane kodowaniem predykcyjnym (termin z badań nad strukturą kory wzrokowej).
Zazwyczaj podczas trenowania sieci neuronowej optymalizowane są jedynie jej wagi. W kodowaniu predykcyjnym optymalizujemy zarówno wagi, jak i aktywacje każdej warstwy: każda warstwa próbuje przewidzieć aktywność kolejnej warstwy, a tylko reszta, której nie udało się wyjaśnić, jest przekazywana w górę. Idea polega na tym, że system musi znaleźć lokalną równowagę między błędem predykcji dochodzącym z dołu i z góry, a następnie wyniki sieci będą dokładnie przewidywać zmienną docelową.
To podejście nie zostało wymyślone przez Sakana AI; jest dość dobrze znane. Niestety, nie działało: w głębokich sieciach sygnał po prostu zanika, a nic się nie uczy, ponieważ sieć nie wie, w którym kierunku przesunąć wagi.
Sakana dodała tylko jedną małą poprawkę – i metoda zaczęła skutecznie trenować sieci nawet do 1000 warstw. Pomogło dodanie mnożnika Lagrange'a (starego radzieckiego konceptu matematycznego). Już w 1988 roku Yann LeCun pokazał, że jeśli sformułujemy sieć neuronową jako problem optymalizacji z ograniczeniami (jak robi to kodowanie predykcyjne) i przypiszemy mnożnik Lagrange'a λ do każdego ograniczenia, to w stanie równowagi λ jest dokładnie równe gradientowi backprop. Jest to fakt matematyczny, który Sakana postanowiła wykorzystać.
Innymi słowy, podczas gdy standardowe kodowanie predykcyjne dostarcza przybliżony sygnał, podejście Sakany – PC-ALM – zbiega się dokładnie z gradientem backprop w sieciach liniowych, wykorzystując jedynie połączenia z sąsiednimi warstwami, bez pojedynczego globalnego przejścia.
Na różnych benchmarkach PC-ALM niemal dorównuje backprop (różnica około 2 punktów procentowych w dokładności na zbiorze MNIST). I tak, nie ma przewagi w dokładności ani szybkości treningu nad backprop. Prawdopodobnie wygra (docelowo) tylko na sprzęcie neuromorficznym w przyszłości. Ale możemy być bliżej odtworzenia procesu uczenia się żywego mózgu. Poza tym jest to po prostu eleganckie ☕️
Dlaczego to ważne
AnalizaBadanie to zmniejsza przepaść między sztucznymi sieciami neuronowymi a biologicznym uczeniem się, otwierając drogę do bardziej efektywnych, podobnych do mózgu rozwiązań sprzętowych.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami