Sakana AI представили альтернативний спосіб навчання нейросетей, натхненний мозком
Sakana AI представили метод PC-ALM, який поєднує предиктивне кодування та множники Лагранжа для навчання глибоких нейросетей, наближаючись до біологічних механізмів мозку.
Sakana AI представили альтернативний спосіб навчання нейросетей, натхненний мозком
Будь-які сучасні нейросеті, якими ми користуємося, навчаються за допомогою зворотного поширення помилки (backpropagation). Цей алгоритм, розроблений ще у 1970-х роках, досі застосовується повсюдно.
Однак до нього є кілька зауважень. Головним чином, проблема полягає в структурі. Backprop працює строго в три послідовні фази: спочатку сигнал проходить вперед через мережу, формується відповідь, потім сигнал помилки йде від виходу назад до входу, і лише після цього оновлюються ваги. З біологічної точки зору це вкрай неправдоподібно: не існує механізму, який змушував би наші нейрони чекати, поки звідкись, через усі інші нейрони, надійде сигнал помилки, щоб оновитися.
Sakana AI, як відомо, вирізняються саме тим, що натхнюються ідеями з нейронауки. Вони пропонують звернути увагу на підхід під назвою predictive coding (термін із робіт про будову зорової кори мозку).
Зазвичай, коли ми навчаємо нейросеті, оптимізуються лише її ваги. У predictive coding ж ми оптимізуємо і ваги, і самі активації кожного шару: кожен шар намагається передбачити активність наступного шару, і вгору передається лише залишок, який він не зміг пояснити. Ідея в тому, що система повинна знайти локальну рівновагу між помилкою передбачення знизу і зверху, і тоді відповіді мережі будуть добре передбачати цільову змінну.
Цей підхід придумали не в Sakana AI, він досить відомий. Але, на жаль, він не працював: у глибоких мережах сигнал просто затухає, і нічого не навчається, тому що мережа не розуміє, куди рухати ваги.
Sakana внесли лише одну невелику доповнення — і метод став добре навчати мережі до 1000 шарів. Допомогло старе радянське... додавання множника Лагранжа. Ще в 1988 році Ян Лекун показав: якщо записати нейросеті як задачу з обмеженнями (як це робить predictive coding) і присвоїти кожному обмеженню множник Лагранжа λ, то в точці рівноваги λ буде точно дорівнювати градієнту backpropagation. Це математичний факт, який Sakana і вирішили використати.
Тобто, якщо у ванільному predictive coding сигнал приблизний, то в підході Sakana — PC-ALM — він на лінійних мережах точно сходить до градієнту backpropagation, використовуючи лише зв'язок із сусідніми шарами, без єдиного глобального проходу.
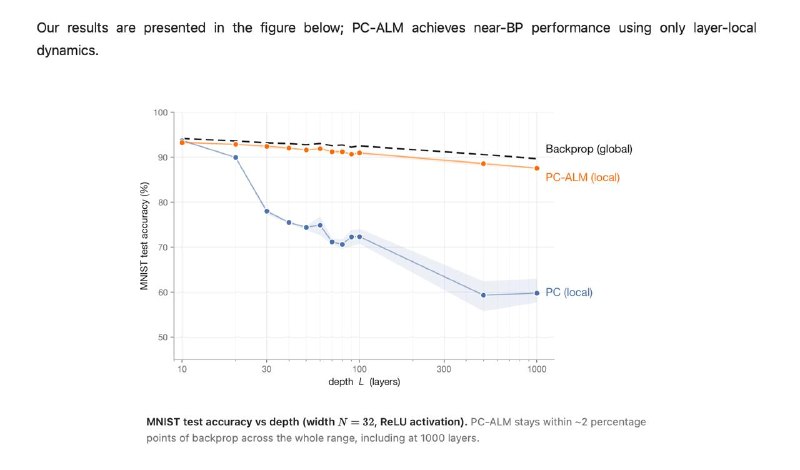
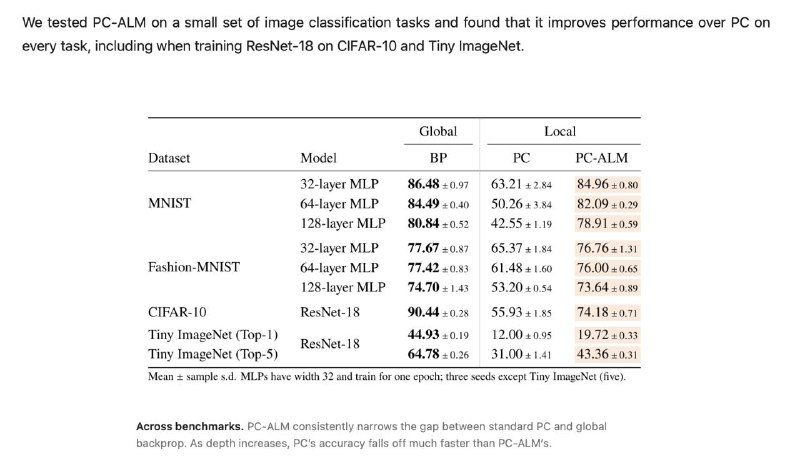
На різних бенчмарках PC-ALM майже не відстає від backpropagation (різниця ~2 п.п. точності на MNIST). І так, переваги в точності або швидкості навчання над backpropagation немає. Вигравати він (можливо) буде тільки на нейроморфних залізних пристроях колись у майбутньому. Зате ми, можливо, стали на крок ближче до того, щоб відтворити процес навчання живого мозку. Ну і просто красиво ☕️
Чому це важливо
АналітикаЦе відкриває шлях до створення ШІ, який навчається локально, без глобального проходження сигналу, що є критичним для енергоефективних нейроморфних чіпів.
Обговорити новину у спільноті
Діліться своїм досвідом та думками з ШІ-розробниками
Пов'язані матеріали екосистеми
Практичні гайди, термінологія та агентські скіли
Analog Anchoring for Engineers
Система регулярних аналогових практик (паперові блокноти, фізичні дошки, прогулянки без гаджетів та мануальна праця) для скидання синтетичного перевантаження та відновлення пластичності мозку.
Профіль Hermes: Методолог навчання та архітектура курсів
Профіль освітнього методолога Hermes: проектування програм за таксономією Блума, мікронавчання, практичні воркшопи та оптимізація Completion Rate.
Дорожня карта: машинне навчання на 2026 рік
Машинне навчання у 2026 році — це не набір окремих алгоритмів і моделей. Це наскрізний процес: від розуміння даних і математики до побудови автономних систем, які можуть планувати, приймати рішення і діяти в реальному середовищі.
Навчання в контексті (In-Context Learning простими словами)
Дивовижна емерджентна властивість великих мовних моделей миттєво засвоювати нові правила, невідомі слова чи унікальні формати просто з тексту поточної розмови без зміни ваг нейромережі та без програмування.