Sakana AI propone un método de entrenamiento de redes neuronales inspirado en el cerebro
Sakana AI presenta PC-ALM, un enfoque que combina la codificación predictiva con multiplicadores de Lagrange para entrenar redes profundas localmente, imitando procesos biológicos.
Sakana AI propone un método de entrenamiento de redes neuronales inspirado en el cerebro
Todas las redes neuronales modernas que utilizamos se entrenan mediante la retropropagación del error (backpropagation). Este algoritmo, inventado en la década de 1970, sigue siendo el estándar universal.
Sin embargo, existen varias críticas al respecto. Principalmente, el problema radica en su estructura. El backprop funciona estrictamente en tres fases secuenciales: primero, la señal viaja hacia adelante a través de la red para producir una salida; luego, la señal de error viaja hacia atrás desde la salida hasta la entrada; y solo entonces se actualizan los pesos. Biológicamente, esto es altamente improbable: no existe ningún mecanismo que obligue a nuestras neuronas a esperar a que llegue una señal de error desde algún lugar a través de todas las demás neuronas antes de poder actualizarse.
Sakana AI es conocida por inspirarse en ideas de la neurociencia. Proponen mirar hacia un enfoque llamado codificación predictiva (predictive coding), un término derivado de la investigación sobre la estructura de la corteza visual.
Normalmente, cuando entrenamos una red neuronal, solo se optimizan sus pesos. En la codificación predictiva, optimizamos tanto los pesos como las activaciones de cada capa: cada capa intenta predecir la actividad de la siguiente capa, y solo el residuo que no pudo explicar se pasa hacia arriba. La idea es que el sistema debe encontrar un equilibrio local entre el error de predicción desde abajo y desde arriba, y entonces las salidas de la red predecirán con precisión la variable objetivo.
Este enfoque no fue inventado por Sakana AI; es bastante conocido. Pero, desafortunadamente, no funcionaba: en redes profundas, la señal simplemente se atenúa y no se aprende nada porque la red no sabe hacia dónde mover los pesos.
Sakana añadió solo un pequeño ajuste — y el método comenzó a entrenar redes de hasta 1000 capas con eficacia. Ayudó la adición de un multiplicador de Lagrange (un concepto matemático antiguo). Ya en 1988, Yann LeCun demostró que si formulas una red neuronal como un problema de optimización con restricciones (como hace la codificación predictiva) y asignas un multiplicador de Lagrange λ a cada restricción, entonces en el punto de equilibrio, λ es exactamente igual al gradiente de backprop. Este es un hecho matemático que Sakana decidió aprovechar.
En otras palabras, mientras que la codificación predictiva vanilla proporciona una señal aproximada, el enfoque de Sakana — PC-ALM — converge exactamente al gradiente de backprop en redes lineales utilizando solo conexiones con capas vecinas, sin un único paso global.
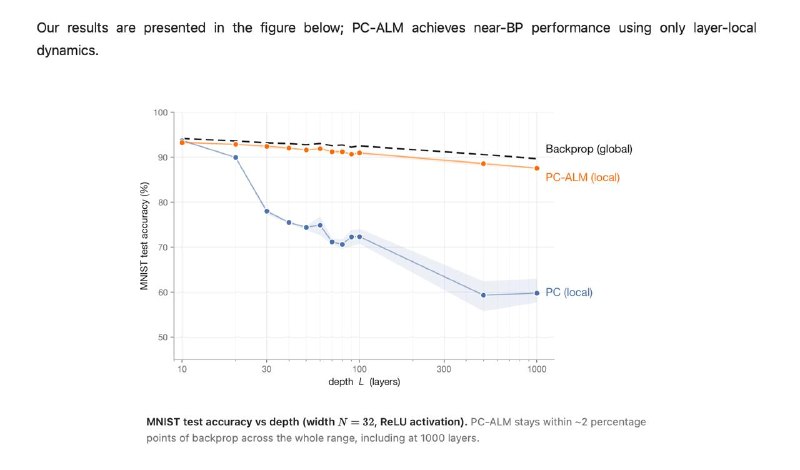
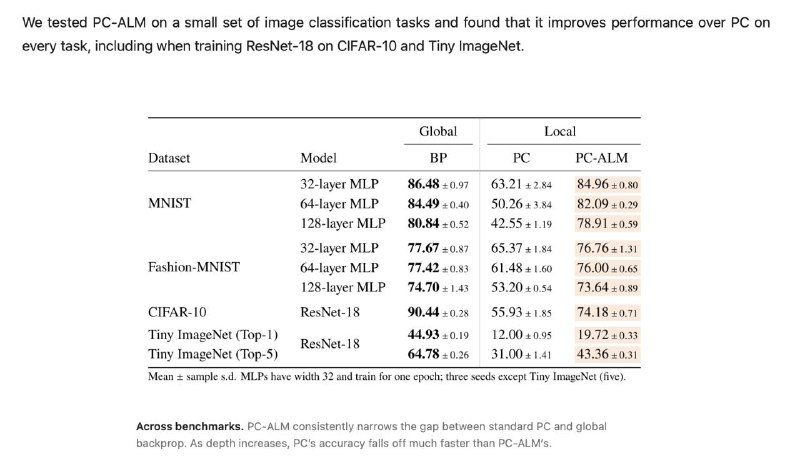
En varios benchmarks, PC-ALM casi iguala al backprop (una diferencia de ~2 puntos porcentuales en precisión en MNIST). Y sí, no hay ventaja en precisión o velocidad de entrenamiento sobre el backprop. Probablemente ganará (eventualmente) solo en hardware neuromórfico en el futuro. Pero tal vez hemos dado un paso más cerca de recrear el proceso de aprendizaje del cerebro vivo. Además, es simplemente elegante ☕️
Por qué es importante
AnálisisEsta investigación cierra la brecha entre las redes neuronales artificiales y el aprendizaje biológico, permitiendo potencialmente una IA más eficiente y similar al cerebro.
Debatir en la comunidad
Comparte tus preguntas e ideas con desarrolladores
Relacionado en el ecosistema
Guías prácticas, terminología y skills de agentes
Anclaje Analógico para Ingenieros
Sistema de prácticas análogas regulares (cuadernos de papel, pizarras físicas, paseos sin dispositivos y trabajo manual) para descargar la sobrecarga sintética y restaurar la plasticidad cerebral.
Pesos y Sesgos de Redes Neuronales (Weights & Biases)
La naturaleza fundamental de una red neuronal entrenada. Los pesos (Weights) son coeficientes matriciales de la fuerza de conexión entre neuronas artificiales, mientras que los sesgos (Biases) son el umbral de sensibilidad de activación. Explicación de los formatos de almacenamiento (.safetensors, bfloat16, fp8) e inspección de pesos a través de Python y CLI.
Perfil Hermes: Generador de Carruseles Virales para Redes Sociales
Pipeline de contenido multiagente para Hermes: narrativa de diapositivas para LinkedIn e Instagram, prompts visuales, ganchos de atención y control de calidad.
Investigadores del MIT muestran que un LLM puede leer y editar pesos de modelos sin entrenamiento
El equipo de MIT CSAIL presentó Weight-Space Programming: Astra leyó y modificó los pesos de Qwen3.5-0.8B sin descenso de gradiente ni fine-tuning, mejorando sus resultados en benchmarks matemáticos.