Sakana AI Propõe Alternativa Inspirada no Cérebro para Treinamento de Redes Neurais
A Sakana AI apresenta o PC-ALM, um método que combina codificação preditiva e multiplicadores de Lagrange para treinar redes profundas localmente, imitando processos biológicos de aprendizagem.
Sakana AI Propõe Alternativa Inspirada no Cérebro para Treinamento de Redes Neurais
Todas as redes neurais modernas utilizadas hoje são treinadas via retropropagação (backpropagation). Este algoritmo, inventado na década de 1970, continua sendo onipresente.
No entanto, existem várias críticas a ele. O principal problema reside em sua estrutura. A retropropagação funciona estritamente em três fases sequenciais: primeiro, o sinal passa pela rede para produzir uma saída; em seguida, o sinal de erro viaja da saída para a entrada; e somente então os pesos são atualizados. Biologicamente, isso é altamente implausível: não há mecanismo que force nossos neurônios a esperar por um sinal de erro vindo de outros neurônios antes de poderem se atualizar.
A Sakana AI é conhecida por buscar inspiração na neurociência. Eles propõem olhar para uma abordagem chamada codificação preditiva (um termo derivado da pesquisa sobre a estrutura do córtex visual).
Normalmente, ao treinar uma rede neural, apenas seus pesos são otimizados. Na codificação preditiva, otimizamos tanto os pesos quanto as ativações de cada camada: cada camada tenta prever a atividade da próxima camada, e apenas o resíduo que ela não conseguiu explicar é passado para cima. A ideia é que o sistema deve encontrar um equilíbrio local entre o erro de previsão vindo de baixo e de cima, fazendo com que as saídas da rede prevejam com precisão a variável alvo.
Essa abordagem não foi inventada pela Sakana AI; ela é bem conhecida. Infelizmente, não funcionava: em redes profundas, o sinal simplesmente atenua, e nada aprende porque a rede não sabe como ajustar os pesos.
A Sakana adicionou um pequeno ajuste — e o método começou a treinar redes com até 1000 camadas efetivamente. A adição de um multiplicador de Lagrange (um conceito matemático antigo) ajudou. Já em 1988, Yann LeCun demonstrou que, se você formular uma rede neural como um problema de otimização restrita (como faz a codificação preditiva) e atribuir um multiplicador de Lagrange λ a cada restrição, então, no equilíbrio, λ é exatamente igual ao gradiente da retropropagação. Este é um fato matemático que a Sakana decidiu aproveitar.
Em outras palavras, enquanto a codificação preditiva padrão fornece um sinal aproximado, a abordagem da Sakana — PC-ALM — converge exatamente para o gradiente da retropropagação em redes lineares usando apenas conexões com camadas vizinhas, sem uma única passagem global.
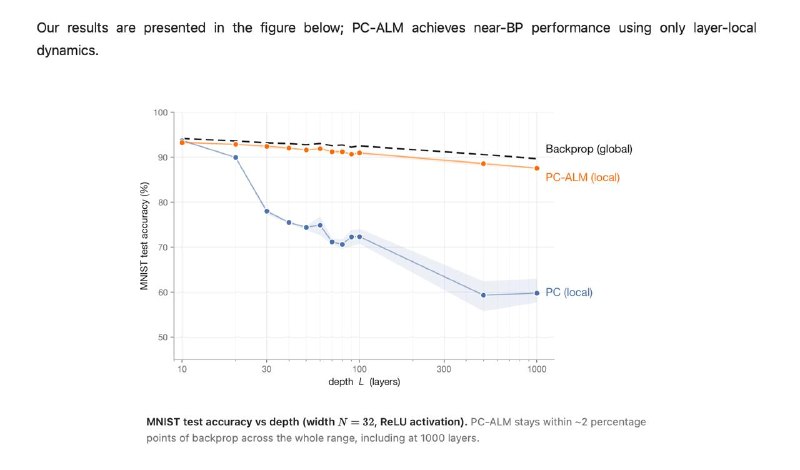
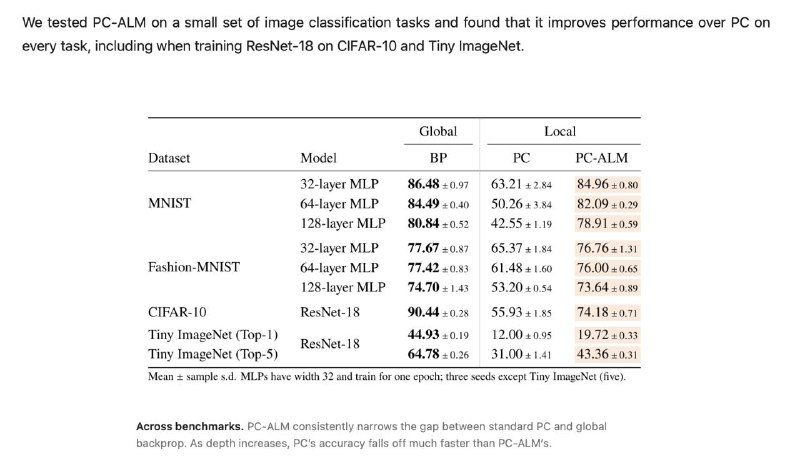
Em diversos benchmarks, o PC-ALM quase iguala a retropropagação (uma diferença de ~2 pontos percentuais na acurácia no MNIST). E sim, não há vantagem em termos de acurácia ou velocidade de treinamento sobre a retropropagação. Provavelmente, vencerá (eventualmente) apenas em hardware neuromórfico no futuro. Mas podemos ter dado um passo mais perto de recriar o processo de aprendizado de um cérebro vivo. Além disso, é simplesmente elegante ☕️
Por que isso importa
AnáliseEsta pesquisa reduz a lacuna entre redes neurais artificiais e o aprendizado biológico, potencialmente viabilizando hardware de IA mais eficiente e semelhante ao cérebro.
Debater na comunidade
Compartilhe suas dúvidas e insights com desenvolvedores