Sakana AI stellt hirngestützte Alternative für das Training neuronaler Netze vor
Sakana AI präsentiert PC-ALM, eine Methode, die prädiktives Codieren mit Lagrange-Multiplikatoren kombiniert, um tiefe Netzwerke lokal zu trainieren und biologische Lernprozesse nachzubilden.
Sakana AI stellt hirngestützte Alternative für das Training neuronaler Netze vor
Alle modernen neuronalen Netze, die wir heute nutzen, werden über Backpropagation trainiert. Dieser Algorithmus, der in den 1970er-Jahren erfunden wurde, ist nach wie vor allgegenwärtig.
Dennoch gibt es mehrere Kritikpunkte an diesem Verfahren. Das Hauptproblem liegt in seiner Struktur. Backpropagation arbeitet streng sequenziell in drei Phasen: Zuerst wird das Signal durch das Netzwerk nach vorne propagiert, um eine Ausgabe zu erzeugen; dann wandert das Fehlersignal von der Ausgabe zurück zum Eingang; erst danach werden die Gewichte aktualisiert. Biologisch ist dies höchst unplausibel: Es gibt keinen Mechanismus, der unsere Neuronen zwingt, auf ein Fehlersignal zu warten, das von irgendwoher durch alle anderen Neuronen hindurchreist, bevor sie ihre Synapsen aktualisieren können.
Sakana AI ist bekannt dafür, sich von den Neurowissenschaften inspirieren zu lassen. Sie schlagen vor, einen Ansatz namens Predictive Coding (prädiktives Codieren) in Betracht zu ziehen – ein Begriff aus der Forschung zur Struktur des visuellen Kortex.
Normalerweise werden beim Training eines neuronalen Netzes nur dessen Gewichte optimiert. Beim Predictive Coding werden sowohl die Gewichte als auch die Aktivierungen jeder Schicht optimiert: Jede Schicht versucht, die Aktivität der nächsten Schicht vorherzusagen, und nur das Residuum, das sie nicht erklären konnte, wird nach oben weitergegeben. Die Idee dahinter ist, dass das System ein lokales Gleichgewicht zwischen dem Vorhersagefehler von unten und von oben finden muss, woraufhin die Ausgaben des Netzwerks die Zielvariable präzise vorhersagen.
Dieser Ansatz wurde nicht von Sakana AI erfunden; er ist in der Fachwelt durchaus bekannt. Leider funktionierte er jedoch nicht gut: In tiefen Netzwerken schwächt sich das Signal einfach ab, und nichts lernt, weil das Netzwerk nicht weiß, wohin die Gewichte bewegt werden sollen.
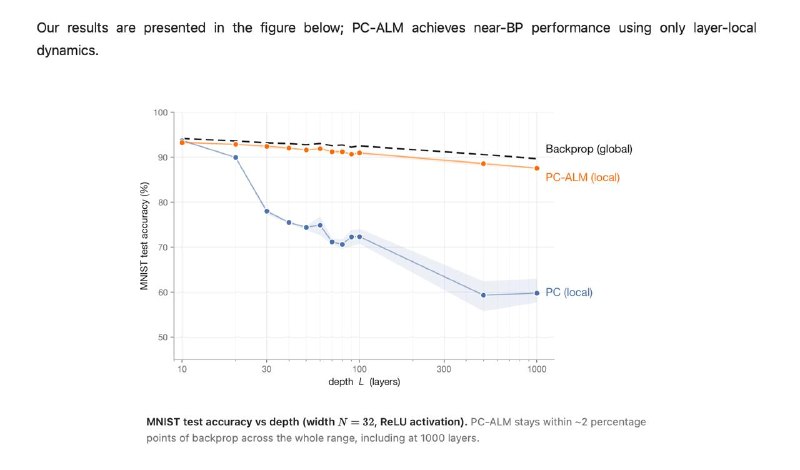
Sakana fügte nur eine kleine Modifikation hinzu – und die Methode begann, Netzwerke mit bis zu 1000 Schichten effektiv zu trainieren. Der Schlüssel lag in der Einführung eines Lagrange-Multiplikators (ein altes mathematisches Konzept aus der sowjetischen Ära). Bereits 1988 zeigte Yann LeCun, dass, wenn man ein neuronales Netz als Problem der eingeschränkten Optimierung formuliert (wie es Predictive Coding tut) und jedem Zwang einen Lagrange-Multiplikator λ zuweist, dieser im Gleichgewichtszustand exakt dem Backpropagation-Gradienten entspricht. Dies ist eine mathematische Tatsache, die Sakana nun gezielt nutzt.
Mit anderen Worten: Während das herkömmliche Predictive Coding nur ein approximatives Signal liefert, konvergiert Sakana’s Ansatz – PC-ALM – bei linearen Netzwerken exakt gegen den Backpropagation-Gradienten, wobei er sich ausschließlich auf Verbindungen zu benachbarten Schichten stützt, ohne einen einzigen globalen Durchlauf zu benötigen.
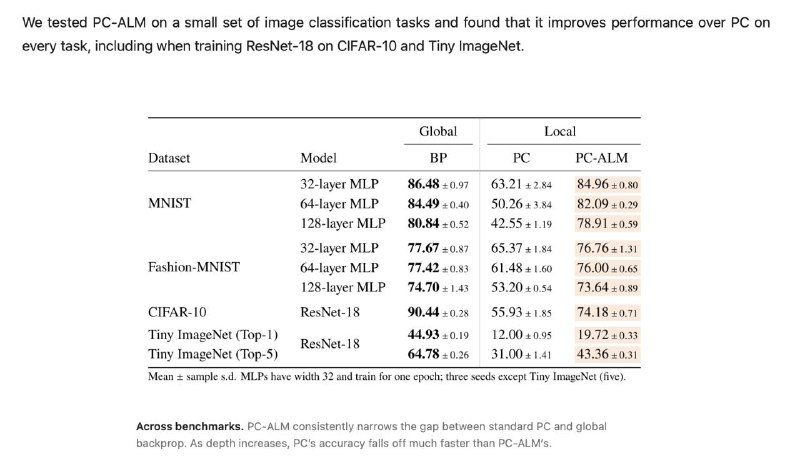
Auf verschiedenen Benchmarks erreicht PC-ALM nahezu die Leistung von Backpropagation (eine Differenz von etwa 2 Prozentpunkten in der Genauigkeit auf MNIST). Und ja, es gibt keinen Vorteil in Bezug auf Genauigkeit oder Trainingsgeschwindigkeit gegenüber Backpropagation. Es wird wahrscheinlich (irgendwann) nur auf neuromorpher Hardware gewinnen. Aber wir sind möglicherweise einen Schritt näher daran gekommen, den Lernprozess eines lebenden Gehirns nachzubilden. Außerdem ist es einfach elegant ☕️
Warum das wichtig ist
AnalyseDiese Forschung schließt die Lücke zwischen künstlichen neuronalen Netzen und biologischem Lernen und könnte langfristig effizientere, gehirnähnliche KI-Hardware ermöglichen.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern